Todos los periódicos y la radio, en unoEscrito por IA a partir de Hacker News · Cómo se hace
Hacker News
Inteligencia artificial · trakkr.ai
Estadísticas zombi: de dónde salen las cifras que citan las IA
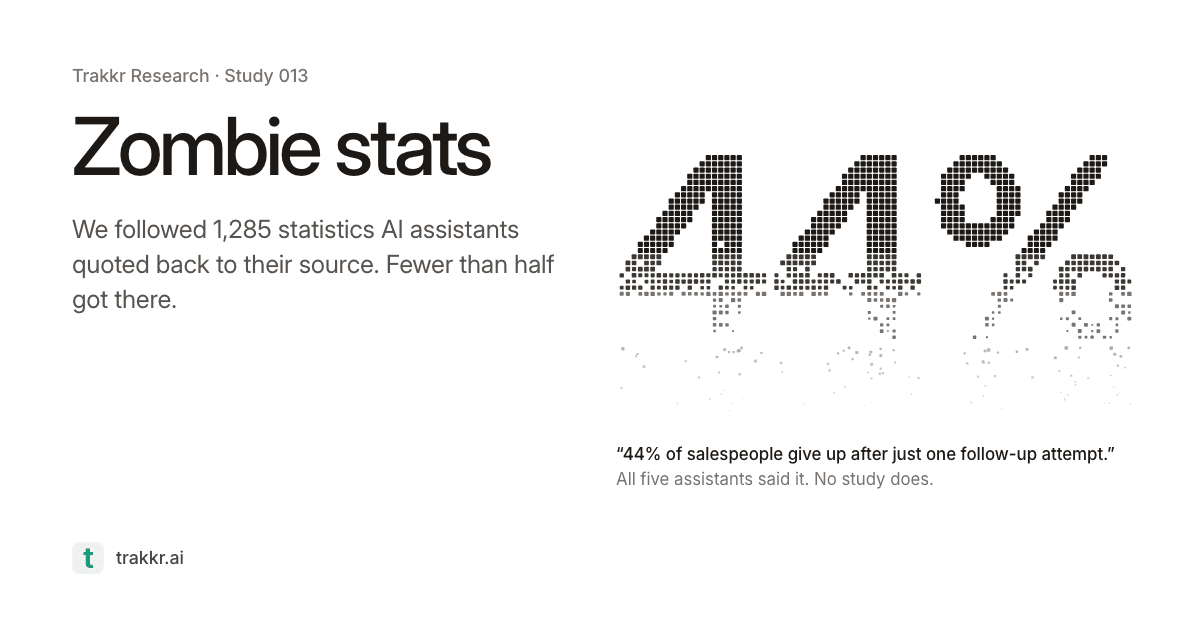
Trakkr, una empresa de análisis, preguntó a ChatGPT, Perplexity, Gemini, Claude y Google AI Overviews 200 cuestiones que piden una cifra y rastreó 1.285 estadísticas citadas. Solo el 40% llegó a un estudio que dice lo mismo; el resto se pierde por el camino.
Foto: vía trakkr.ai
1 medio · MadridPublicada 29 oct, 16:45Actualizada 29 oct, 18:25· Ya no está en portadaEscrita por IA · cómo funciona
El informe parte de un ejemplo: a la pregunta de qué porcentaje de comerciales abandona tras un solo seguimiento, los cinco asistentes dieron un 44%. Google AI Overviews citaba la página de estadísticas de una empresa de ventas, de 2020, cuyo enlace de «fuente» llevaba a un texto de muestra de una redactora freelance, en línea en 2017. Ese texto lleva la cifra en el titular, pero ninguno de sus enlaces es un estudio sobre seguimientos. No hay encuesta, ni muestra, ni fecha: una estadística «zombi».
Para medir el alcance, Trakkr tomó una muestra aleatoria de 1.285 estadísticas citadas y siguió cada rastro hasta cinco páginas de profundidad. El 40% llegó a un estudio que dice lo mismo y otro 8% llegó al estudio, pero con la cifra o el contexto cambiados. Un 40% se detuvo en una fuente imposible de comprobar (bloqueada, desaparecida o sin la cifra) y un 11% no llevó a ninguna parte. Por asistente, ChatGPT sale mejor (57%) y cita menos cifras por respuesta (1,3, frente a 6,8 de Claude). Perplexity logra un 46%, AI Overviews un 39% y Gemini y Claude un 38%; estos cuatro últimos, según el informe, no se pueden ordenar entre sí.
Los asistentes casi nunca se inventan el número: la página citada contenía la cifra el 82% de las veces. El problema es qué página: solo el 21% de las citadas era la investigación original. Más de la mitad eran blogs de empresas, y sumando noticias y recopilatorios de estadísticas, la mayoría son páginas que recogen cifras ajenas, a menudo sin enlazar. Si el rastro empieza en una firma de investigación o en un organismo público, llega a un estudio coincidente en torno al 61-62% de los casos; desde un blog de empresa, el 37%, y desde un recopilatorio, el 35%.
Incluso al llegar al estudio, en el 17% de los casos algo había cambiado por el camino. Los dígitos solo se movían una de cada cuatro veces; lo habitual era el contexto: qué se medía, el año, la fuente o a quién se preguntó. Un ejemplo: un estudio de 2004 con 15 mujeres británicas que juzgaban webs de salud (el 94% de sus comentarios sobre el rechazo de una web eran de diseño) acabó convertido en «el 94% de las primeras impresiones de una web son de diseño». Además, los asistentes discrepan entre sí: en 28 de las 71 preguntas en que los cinco dieron un porcentaje hubo cuatro o cinco cifras distintas, y en una sobre el uso de automatización de marketing iban del 49% al 96%.
«Zombie stats: Where the numbers AI quotes come from» · puesto 30 · 148 puntos · enviado por mektrik
Lo que dicen los comentarios
Los comentarios se reparten entre el deseo de herramientas que verifiquen de verdad, las dudas sobre Perplexity y las críticas al propio informe. Hay quien lo tacha de anuncio apenas disimulado de Trakkr y de relleno, aunque admite que el problema merece discusión; otro duda de si el estilo del texto es pereza o ironía. Se habla de la falsa seguridad que da un «[1]» junto a una cifra y de lo mucho que se repite una cifra sin fuente (el 70% de PHP). Un comentarista rebate ese número con datos de HTTP Archive y W3Techs. También hay quejas sobre Google, que inventa significados de palabras suecas.
Para mí el sueño de la IA es que un agente haga el trabajo pesado de rastrear cada afirmación hasta su referencia. No se usa para eso: queremos «respuestas» más rápidas que eviten la diligencia debida. Lo de siempre, pero más perezoso.
Me pregunto qué soluciones existen: una capa sobre un LLM que registre la procedencia: los documentos a los que accede, los hechos extraídos, las consultas ejecutadas y los resultados, con el detalle de cómo llegó a sus conclusiones. ¿Hay algo así en GitHub?
También hay un factor humano: ¿comprobarán los usuarios las citas? Al principio, en ChatGPT y Perplexity muchas no funcionaban (inventadas o 404). Un «[1]» junto a una cifra da una falsa sensación de seguridad.
Un anuncio apenas disimulado de algo llamado Trakkr. Además, estas «estadísticas» no importan salvo como material para la presentación de un consultor, y entonces su exactitud da igual.
En el rastreo de septiembre de 2026 de HTTP Archive, PHP aparece en 4,22 M de 8,74 M de orígenes móviles: el 48,3%. El 70% probablemente viene de W3Techs (69,2%), pero solo sobre sitios con lenguaje de servidor conocido, y PHP es muy fácil de detectar.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.