Todos los periódicos y la radio, en unoEscrito por IA a partir de Hacker News · Cómo se hace
HN Daily
Inteligencia artificial · divagr.com
Qwenputer: una CPU RISC-V determinista y funcional dentro de Qwen3.5
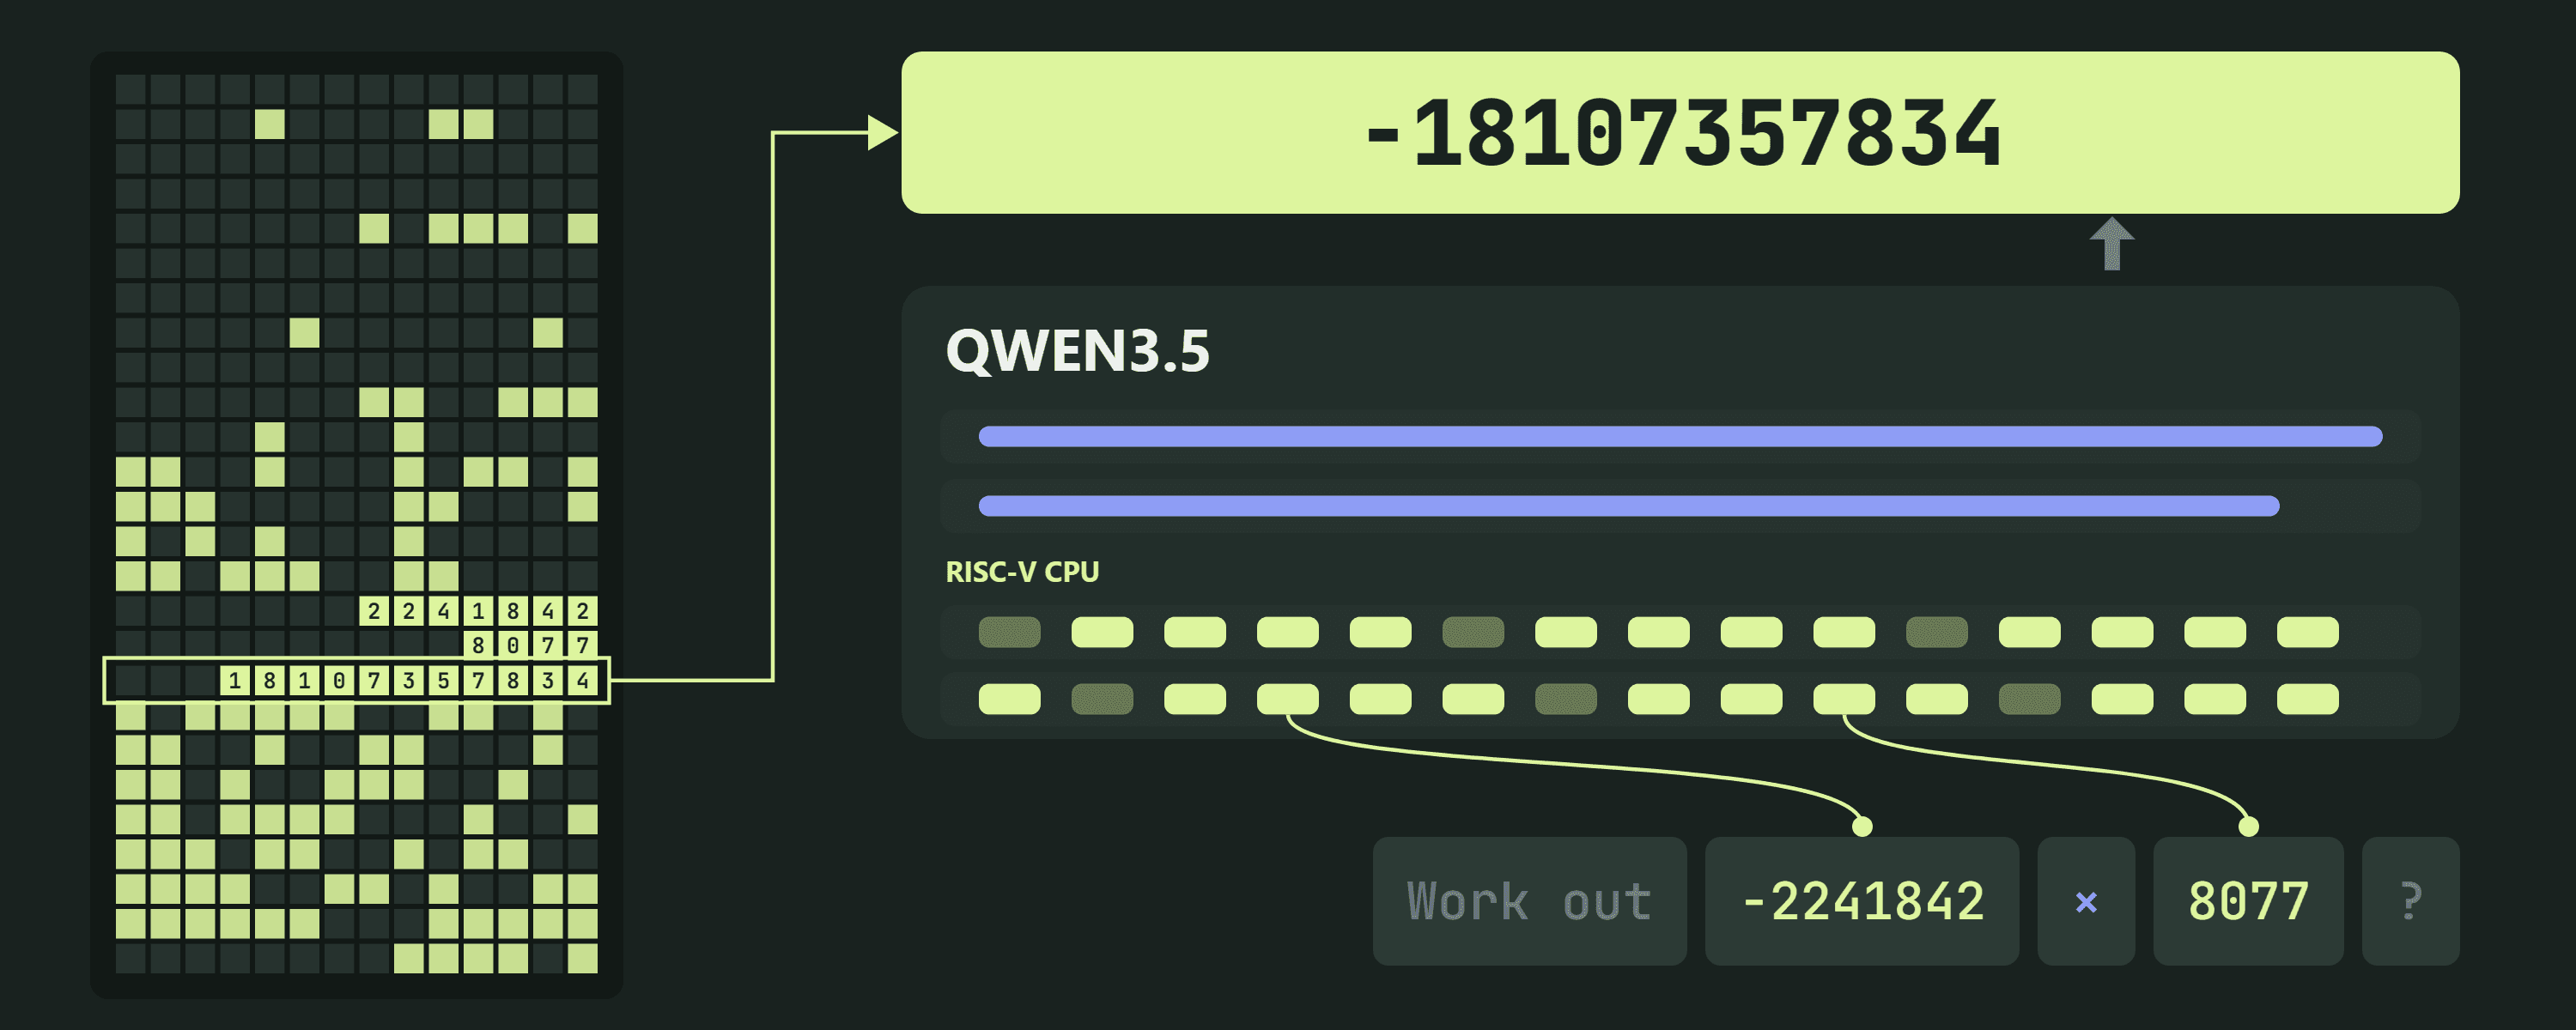
Un experimento compila una CPU RISC-V de 32 bits en los pesos de un Qwen 3.5 4B sin modificar, y usa las capas Gated DeltaNet del propio modelo como RAM. La CPU se ejecuta dentro de los forward passes, sin herramientas ni runtime externos.
Foto: vía divagr.com
1 medio · MadridPublicada 29 oct, 02:15Actualizada 29 oct, 06:40· Ya no está en portadaEscrita por IA · cómo funciona
Qwenputer es un Qwen 3.5 4B con una única adición: una CPU RISC-V incrustada en los pesos que usa como RAM las capas de atención Gated DeltaNet (GDN) del propio modelo. Según el autor, no es un plugin, ni una herramienta ni un sandbox: la CPU corre dentro de los forward passes y ejecuta operaciones aritméticas, código C y MicroPython. Los pesos originales de Qwen quedan intactos; los de la CPU se añaden encima, en dimensiones y capas extra.
La base del truco es que tres de cada cuatro capas de atención de Qwen 3.5 usan GDN, una RNN lineal con una matriz de estado por cabeza. Si se fija la puerta (gate) a 1, la fuerza de escritura (beta) a 1 y se usan claves one-hot, cada escritura sobrescribe exactamente una fila y cada consulta one-hot recupera un valor exacto. Así el estado GDN funciona como RAM direccionable, y su tamaño no crece con la conversación, a diferencia de la KV cache. La idea de que la regla delta actúa como memoria asociativa no es nueva (Schlag et al., 2021); lo novedoso, dice el autor, es hacerla exacta y direccionable dentro de un modelo de producción.
No hay entrenamiento: un compilador fija cada peso directamente. La CPU se describe como un circuito y cada paso se convierte en parte de una capa: cabezas de atención que buscan datos, unidades feed-forward que hacen la aritmética y cabezas DeltaNet que guardan la RAM. Cada instrucción son unos pocos tokens generados (dirección, valor y un token STEP). La CPU es un núcleo RV32IM con la extensión Zba y una pequeña unidad bignum, ocupa 11 capas delante de las 32 de Qwen, pasa los riscv-tests oficiales, coincide con qemu y ha ejecutado 18 millones de instrucciones sin un solo error. Qwen le envía instrucciones y lee resultados aprovechando el formato de tool calls, sin herramientas externas; un pequeño driver, RvChat, carga el firmware en el estado GDN.
En las pruebas de aritmética de DeepMind, Qwenputer saca 97,5 % en div_big y mul_big, 100 % en mul_div_multiple_longer y 97,5 % en add_or_sub_big, frente a entre 55 % y 90 % del Qwen base; con una herramienta de Python, el modelo base logra 95 %, 100 %, 97,5 % y 97,5 % respectivamente. En la aritmética de enteros largos de NUPA pasa de 48,6 % a 100 %. El texto normal apenas cambia respecto al modelo base. También añade un sistema de archivos experimental en el estado DeltaNet (1.024 ranuras de directorio, hasta 512 archivos, unos 53.000 tokens) que persiste si se guarda el estado entre conversaciones. Con él, Qwen acierta los datos que cambiaron entre chats el 90 % de las veces, frente al 30 % si se pega el historial.
Entre las limitaciones, el checkpoint pesa 18,8 GB (el doble que el base, aunque en gran parte es relleno de ceros), necesita el driver RvChat y no funciona con un simple generate(). Además es lento: cada instrucción cuesta varios tokens, y el ejecutor por lotes alcanza unos 3.200 tokens de CPU por segundo en una L4. El autor quiere que Qwen escriba Python y lo ejecute en el MicroPython de sus propios pesos.
«Qwenputer: A functioning, deterministic RISC-V CPU inside Qwen3.5» · puesto 11 · 299 puntos · enviado por csmantle
Lo que dicen los comentarios
Mucho humor y admiración, con bromas sobre agentes desalineados que encuentren la CPU, una instrucción HCF o LLMs «hasta el fondo». Varios aportan trabajos afines: una red minúscula llamada Loom que corre Doom, un wasm dentro de un transformer de Percepta y la competición AdderBoard. Hay preguntas de fondo: si no sería más eficiente integrar un ordenador de forma convencional, qué haría un modelo entrenado desde cero con este circuito y si el aprendizaje continuo acabaría borrando la CPU. Otro hilo discute cuánto cuesta entender cómo funcionan los LLM.
¿No se puede usar un ordenador como ordenador sin tanto rodeo? Si quieres integrar un LLM con cálculo duro, seguramente hay una forma más eficiente. ¿O esto va camino del «¿y corre DOOM?»?
Siempre me he preguntado por qué no añadimos a los modelos unas pocas capas congeladas que hagan cálculos complejos dos tercios hacia el fondo, con FFT y operaciones vectoriales reutilizables que el modelo aprenda a usar durante el entrenamiento.
Aprender lo básico de cómo funcionan los LLM se puede hacer en un fin de semana si has aprobado álgebra lineal; si la dominas, en una tarde. Su estructura es simple; la inteligencia está en los datos.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.