Todos los periódicos y la radio, en unoEscrito por IA a partir de Hacker News · Cómo se hace
HN Daily
Inteligencia artificial · minimaxir.com
OpenAI y Anthropic recortan hasta un 80 % los precios de sus LLM en pocos meses. ¿Por qué?
Max Woolf repasa la secuencia de bajadas de precio de OpenAI y Anthropic entre junio y septiembre de 2026. Atribuye el movimiento a la competencia entre ambas y, sobre todo, a la presión de los modelos de pesos abiertos, cada vez más capaces y servidos por decenas de proveedores.
Foto: vía minimaxir.com
1 medio · MadridPublicada 25 oct, 22:40Actualizada 26 oct, 02:40· Ya no está en portadaEscrita por IA · cómo funciona
El artículo arranca con una cronología de lanzamientos. En junio, OpenAI presentó GPT-5.6 Sol (5 $ / 30 $ / 0,50 $ por millón de tokens de entrada, salida y lectura de caché) y Luna, un modelo pequeño a 1 $ / 6 $ / 0,10 $. Anthropic lanzó Claude Sonnet 5 con un precio de lanzamiento de 2 $ / 10 $ / 0,20 $ y, el 24 de julio, Opus 5 a 5 $ / 25 $ / 0,50 $. El 30 de julio OpenAI rebajó Luna un 80 %, hasta 0,20 $ / 1,20 $ / 0,02 $.
Siguieron más movimientos: Anthropic hizo permanente el precio de Sonnet 5 y OpenAI rebajó Sol un 20 % durante tres meses. El 1 de septiembre, Anthropic lanzó Fable 5.1 con la lectura de caché un 75 % más barata que Fable 5. El 22 de septiembre OpenAI presentó GPT-6 Sol a 2 $ / 10 $ / 0,20 $ y Anthropic, ese mismo día, Opus 5.5 a 4 $ / 20 $ / 0,20 $, con una reducción total de costes del 40-60 % respecto a Opus 5. Una semana después, GPT-6.1 Sol recortó a la mitad el precio de la caché. Según el autor, los modelos no parecen haber perdido calidad por ello, y las rebajas alcanzan también a las suscripciones de Codex y Claude Code.
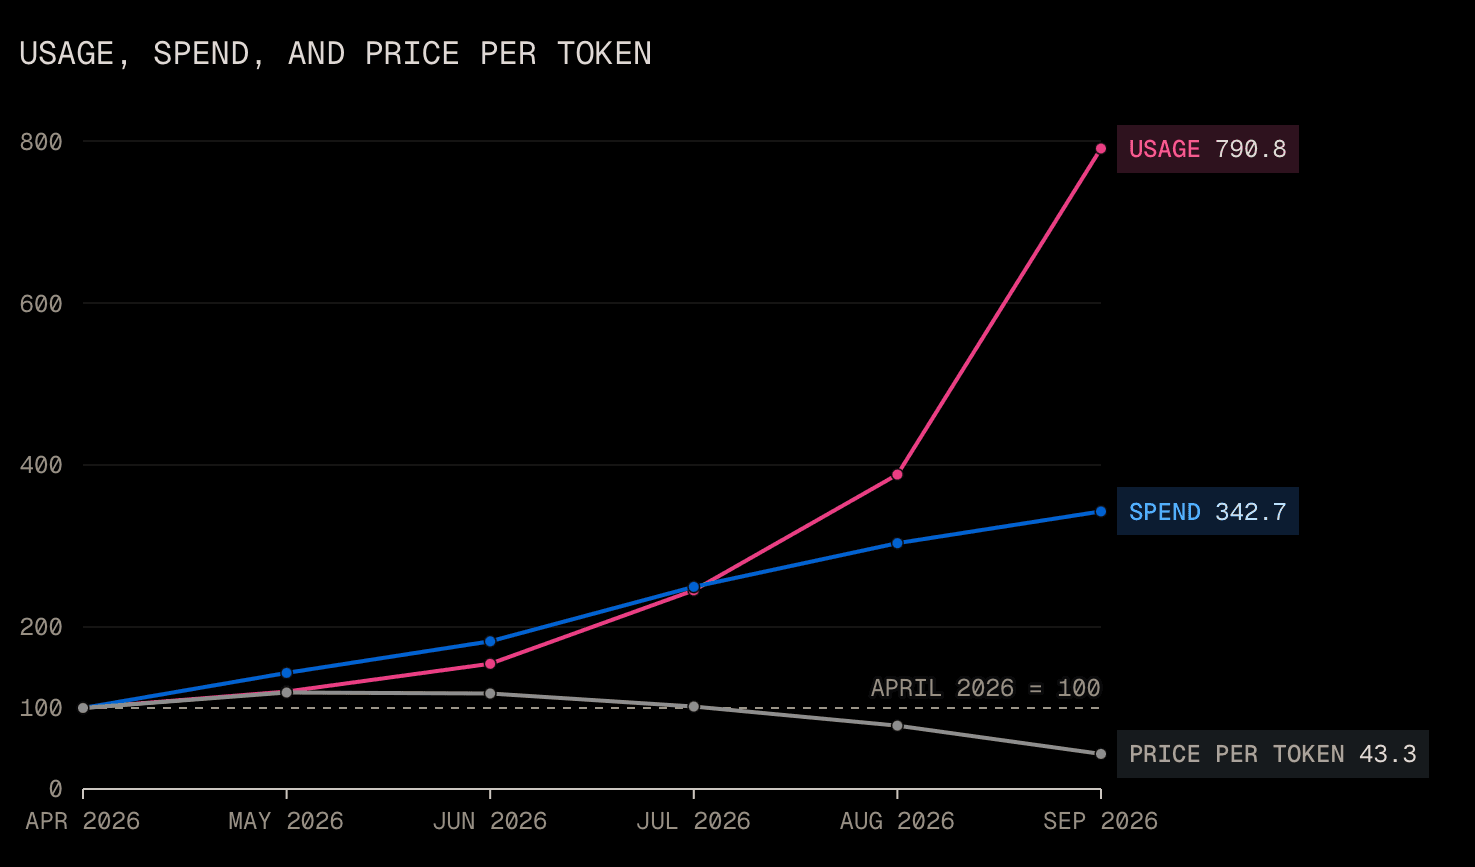
El autor subraya el peso de la caché: en el uso de agentes para programar, la lectura de caché supone entre el 96 % y el 99 % del gasto en tokens, de modo que un recorte del 75 % en ese concepto equivale a bajar entre un 70 % y un 75 % el coste real. Los datos de Vercel muestran que el coste por token cayó al 43,3 % del de abril de 2026, aunque el gasto agregado sigue subiendo porque los modelos mejoran más rápido de lo que abaratan.
Para explicarlo, Woolf apunta a que los modelos se han convertido casi en una commodity: probar uno nuevo es cambiar una opción en OpenCode o Zed, o una cadena en OpenRouter. Suma la presión de los pesos abiertos. DeepSeek V4 Flash tenía 13 proveedores en OpenRouter en mayo y la variante 1017 tiene ya 29, varios con un coste efectivo a menos de un 10 % del de DeepSeek. Kimi K3.1 Pro, de Moonshot AI, rinde cerca de Opus 5.5 (55 frente a 58 en el índice de Artificial Analysis) a la mitad de precio de entrada y salida. Woolf cree que el recorte de Luna iba dirigido a estos modelos, y rebate la teoría de que los precios están artificialmente bajos como los de Uber: aquí no hay un duopolio que fije precios y la barrera de entrada es baja.
«OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?» · puesto 9 · 245 puntos · enviado por minimaxir
Lo que dicen los comentarios
Los comentarios coinciden en general en que la competencia explica las bajadas, y buena parte de la discusión gira en torno a si la inferencia es rentable. Varios citan los números de DeepSeek (unos 38 $ de ingresos por GPU y hora, con un plazo de amortización del hardware de diez meses) como prueba de que servir modelos da beneficios, y dejan abierta la duda de si bastan para cubrir el coste del entrenamiento. Otros son más escépticos: hay quien cree que los LLM no son un negocio viable, quien ve una carrera hacia el fondo insostenible y quien sospecha que las empresas estadounidenses empujarán una regulación que deje fuera a los modelos chinos. También se discute si hay sobreinversión en centros de datos y si la capacidad ociosa de GPU empuja los precios a la baja, y no falta quien atribuye las rebajas simplemente a modelos más pequeños y a un mejor caché.
La competencia baja los precios. Probamos Kimi y GLM tras toparnos con bloqueos de «ciberseguridad» en OpenAI y Anthropic. Eran mucho más baratos y nos dejaron terminar el trabajo sin rechazos.
DeepSeek fija precios con un plazo de amortización del hardware de diez meses y declara unos 38 $ de ingresos por GPU y hora en clústeres de V4.1-Flash. La inferencia es claramente rentable; la duda es si basta para pagar el entrenamiento.
Por eso Anthropic y OpenAI piden más «regulación». No se demuestra retorno a los inversores recortando costes de inferencia. La regulación les molestaría un poco, pero el beneficio es enorme si prohíbe los modelos abiertos chinos.
Probablemente son métodos de caché más eficientes y modelos más pequeños (el 6 Sol sería en realidad un 6 Terra y Opus 5.5 es más pequeño que el 5.1). No le deis más vueltas.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.