Todos los periódicos y la radio, en unoEscrito por IA a partir de Hacker News · Cómo se hace
Hacker News
Ciencia · learnfromx.com
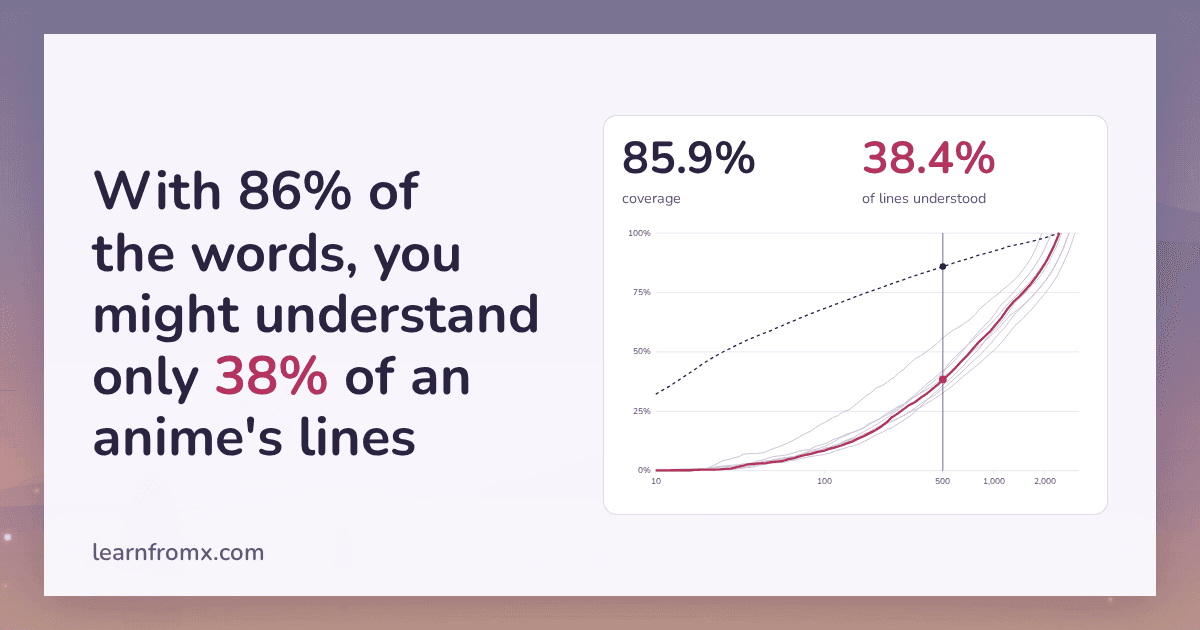
Con el 86 % de las palabras, quizá entiendas solo el 38 % de las frases de un anime
Un análisis de ocho series de anime compara la cobertura de vocabulario, el porcentaje de palabras habladas que conoces, con el de líneas de diálogo que puedes seguir. Con las 500 palabras más comunes de Frieren, la cobertura es del 85,9 %, pero solo se entiende el 38,4 % de las líneas.
Foto: vía learnfromx.com
1 medio · MadridPublicada 31 oct, 22:20Actualizada 1 nov, 00:35· Ya no está en portadaEscrita por IA · cómo funciona
El artículo parte de Frieren: quien aprende las 500 palabras más frecuentes de la serie conoce el 85,9 % de las palabras pronunciadas, pero en las primeras 3.000 líneas solo 1.151 (el 38,4 %) tienen todas sus palabras conocidas. La cobertura cuenta cada repetición, así que partículas como の o は pesan mucho. Con las 100 palabras más comunes, la cobertura es del 68,3 % y las líneas entendidas, el 8,5 %.
La diferencia se explica por la longitud de las frases. Una línea de Frieren tiene de media siete palabras y hay que conocerlas todas: 0,859 elevado a siete da un 35 %, cerca del 38,4 % medido. Las ocho series muestran la misma brecha. Serial Experiments Lain necesita menos vocabulario (unas 400 palabras para la mitad de las líneas) y Jujutsu Kaisen más (980).
De las 1.849 líneas de Frieren que no se entienden con 500 palabras, 1.042 (el 56,4 %) fallan por una sola palabra. Pasar de 500 a 1.000 palabras sube la cobertura 6,5 puntos, pero las líneas entendidas, 22,1. Esas 1.042 líneas necesitan 804 palabras distintas, y ninguna aporta más de cuatro líneas. Las 2.000 palabras más comunes del japonés general dan entre el 23,4 % y el 37,6 % de las líneas; las 2.000 más comunes de cada serie, entre el 74,3 % y el 93,3 %.
Una lista de palabras de los primeros episodios sigue sirviendo después, pero peor: en Frieren, la lista de las primeras 3.000 líneas entiende el 22,3 % de las 3.000 siguientes, frente al 33,0 % de una lista hecha con ellas. El método usa el tokenizador Sudachi, limita cada serie a 3.000 líneas y cuenta una palabra como conocida sea cual sea su acepción, así que las cifras de líneas entendidas pueden ser algo optimistas. El código completo ocupa 29 líneas de Python.
«With 86% of the words, you might understand only 38% of an anime's lines» · puesto 26 · 70 puntos · enviado por lakesare
Lo que dicen los comentarios
Los comentarios se reparten entre la crítica metodológica y las anécdotas. Se señala que el contexto permite entender frases sin conocer cada palabra, aunque otro usuario recuerda que el propio artículo lo admite como limitación. Se discute que algunas palabras del ejemplo estén o no en las 500 más frecuentes, y se aclara que la lista es de cada serie y no de un corpus general. Hay quien cuenta una experiencia parecida aprendiendo alemán y quien enlaza un análisis propio sobre cobertura de frases frente a cobertura de palabras. También hay desvíos hacia el doblaje frente a los subtítulos, el contenido repetitivo como vía de aprendizaje y el carácter deliberadamente críptico de Lain.
Esto ignora que a menudo se puede deducir el sentido de una frase por el contexto aunque no se conozca el significado de cada palabra.
Son las 500 palabras más comunes de esa serie concreta, no de un corpus más amplio, así que habrá palabras que casualmente sean inusualmente comunes o raras.
Me suena bien. Algo parecido me pasó aprendiendo alemán al mudarme de Reino Unido a Berlín, aunque menos extremo: el 85 % de las palabras me daba el 50 % de las frases.
Me recuerda a un análisis mío. Llevo años pensando en la cobertura de frases frente a la de palabras: una transcripción solo con frases i+1 sería incomprensible.
Es irónico que Lain quede primera en líneas comprensibles: el vocabulario no es lo complejo, sino el contenido, surrealista, que invita a unir puntos sin dar suficientes.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.