Todos los periódicos y la radio, en unoEscrito por IA a partir de Hacker News · Cómo se hace
Hacker News
Hardware · blog.google
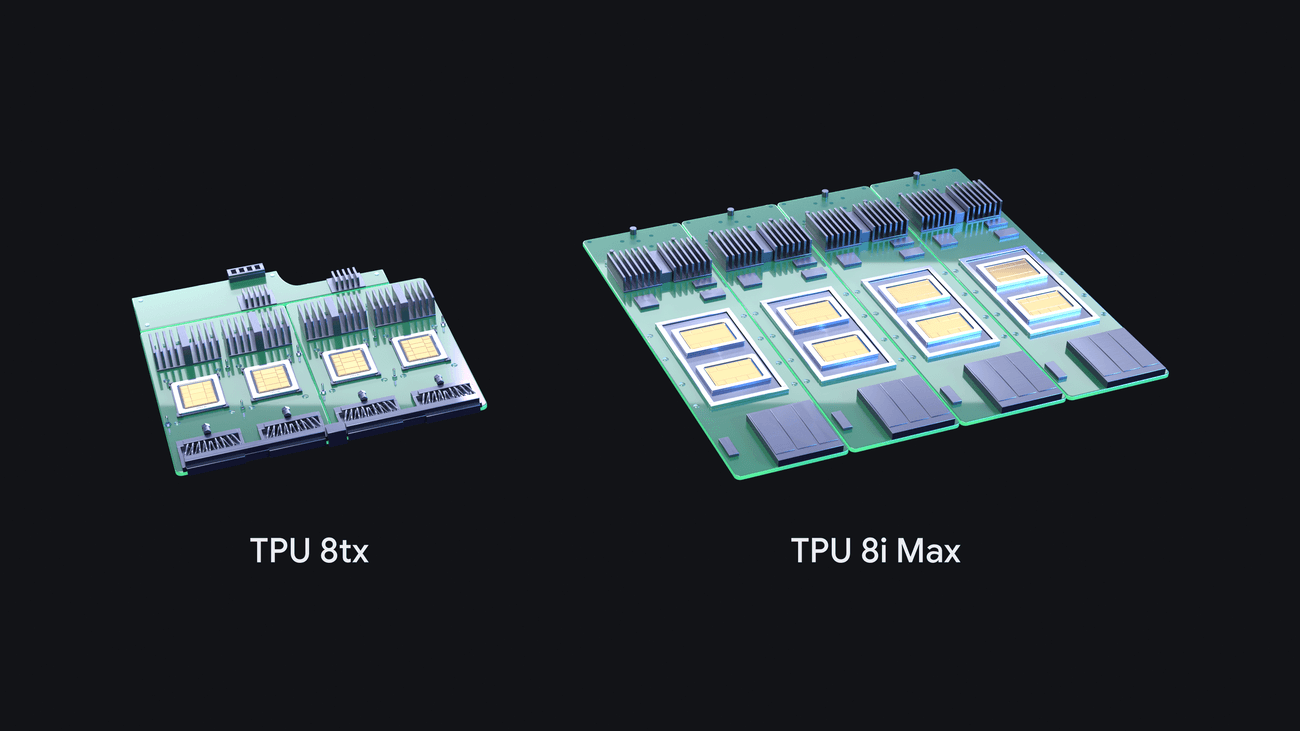
TPU 8tx y TPU 8i Max
Google amplía su octava generación de TPU con dos sistemas nuevos: 8tx, para inferencia segura y confidencial, y 8i Max, con el doble de silicio por paquete para contextos enormes. Son cuatro sistemas TPU en un solo año, y Google insiste en abrir estos chips a cualquier desarrollador de PyTorch.
Foto: vía blog.google
1 medio · MadridPublicada 10 nov, 10:00· Ya no está en portadaEscrita por IA · cómo funciona
Google presenta TPU 8tx y TPU 8i Max, que se suman a los TPU 8t (entrenamiento a gran escala) y 8i (razonamiento en tiempo real) anunciados en abril en Google Cloud Next. Según la compañía, 8t ofrece hasta 2,7 veces más rendimiento de entrenamiento y 8i un 80 % más de rendimiento por precio en inferencia respecto a la generación anterior. Google dice que los TPU tienen ya cerca de 100 clientes, entre ellos laboratorios de frontera, empresas de trading, minoristas y universidades, y que ahora también pueden desplegarse en los centros de datos de los propios clientes.
TPU 8tx, construido sobre el mismo silicio que 8t y emparejado con CPU AMD EPYC de quinta generación, está pensado para empresas reguladas y gobiernos. Protege datos y pesos del modelo incluso mientras se procesan en memoria, y usa la red Boardfly de baja latencia de 8i, con hasta el doble de latencia menor que 8t y una penalización de rendimiento casi nula. Permite además ajustar modelos con datos privados, destilar y entrenar agentes con aprendizaje por refuerzo sin mover los datos a otro clúster.
TPU 8i Max junta dos chips TPU 8i en un solo paquete: doble de cómputo, doble de SRAM y doble de ancho de banda HBM. Al caber en el mismo espacio de rack, ofrece más potencia por metro cuadrado y por vatio. Google lo plantea para agentes que trabajan sobre bases de código enteras o horas de vídeo, donde el ancho de banda de memoria es el cuello de botella.
En el apartado de software, Google dice que liberó el mes pasado TorchTPU, de modo que el código PyTorch y los modelos de Hugging Face corren de forma nativa en TPU, con backends para vLLM y SGLang. Anuncia también una suite open source de agentes para TPU (en preview) que se integra con Claude Code, Cursor y Google Antigravity, y un XLA Serving Engine para servir en un runtime C++ sobre TPU, GPU y CPU. Afirma haber logrado marcas de precio-rendimiento de referencia en los benchmarks InferenceX y AgentX.
«TPU 8tx and TPU 8i Max» · puesto 30 · 247 puntos · enviado por _benx_
Lo que dicen los comentarios
Gran parte de los comentarios critica la falta de datos: se echan en falta especificaciones, cifras de vatios o dólares por token y comparaciones con el precio equivalente de Nvidia, y varios preguntan si es una nota de prensa. Otros responden que es un anuncio de marketing y que hay más detalle técnico en otras fuentes. Se debate también que el texto no explique qué es TPU, y se discute por qué Google no vende estos chips: alguien señala que ya empieza a hacerlo a clientes selectos. Un empleado de Google en este campo sostiene que el lector medio se beneficia de forma indirecta porque los TPU dan competencia a Nvidia. Hay peticiones concretas, como que Google Colab ofrezca TPU más nuevos.
¿Dónde están las cifras de vatios por token o dólares por token de cada uno? ¿Y cómo se comparan con su equivalente de precio en Nvidia?
Es un anuncio de marketing y tiene el nivel de información adecuado para su público objetivo. Si quieres más detalle técnico, hay mucho disponible en otros sitios.
Es una ventaja competitiva que les permite ofrecer menor coste por inferencia. Si la calidad se estanca, lo más interesante será el mejor valor. Y si compiten con Nvidia, quizá la fuerce a bajar precios.
Trabajo en este campo en Google, aunque opino a título personal: te beneficias de forma indirecta, porque da a Nvidia un competidor en el centro de datos y alivia la presión sobre el mercado de GPU. También puedes alquilarlos en GCP.
Ojalá Google Colab empezara a ofrecer un modelo nuevo de TPU: lo más potente que hay en Colab sigue siendo v6e-1, demasiado pequeño para trabajo serio.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.