Uberblok, un museo interactivo de ZFS
Un museo interactivo de ZFS, sala por sala: cada idea del código fuente de OpenZFS hecha visible, con el código real.
Un museo interactivo de ZFS, sala por sala: cada idea del código fuente de OpenZFS hecha visible, con el código real.
El uberblock
Un pool contiene millones de bloques repartidos entre varios discos. Después de una caída, ZFS tiene que encontrar el último estado coherente del pool sin leerlos todos. Parte de un pequeño registro que hay en cada disco, el uberblock. ZFS escribe los cambios por lotes, llamados grupos de transacciones (txg), cada pocos segundos. El uberblock guarda el número del último txg y un puntero a la cima del árbol de bloques del pool. Desde ese puntero se llega a todos los demás bloques.
ZFS nunca escribe un uberblock nuevo encima del actual. Cada disco tiene un anillo de ranuras para uberblocks, y cada txg escribe su uberblock en la ranura siguiente. El uberblock anterior sigue intacto en su ranura, así que, si se va la luz durante la escritura, queda uno bueno en el disco.
Al importar el pool, ZFS lee todas las ranuras, descarta las que no pasan la comprobación y usa el uberblock válido con el txg más alto.
La figura muestra un anillo. Pulsa Siguiente txg para confirmar un txg: el uberblock nuevo ocupa la ranura que sigue a la del anterior, y el anterior se queda en la suya. Con las animaciones activadas, el anillo también confirma un txg cada 1,3 segundos por sí solo, y Siguiente txg lo detiene. Cambia el tamaño de sector de los discos. Una ranura ocupa un sector, y nunca menos de 1 KiB, así que el mismo anillo de 128 KiB tiene 128 ranuras en discos con sectores de 512 bytes y 32 en discos con sectores de 4 KiB.
ub_magic0x00bab10c
ub_txg4211
ub_rootbp→ MOS
Anillo de 32 ranuras de 4 KiB (ashift 12). El uberblock del txg 4211 es el más reciente: ranura 19, porque 4211 mod 32 = 19. El uberblock del txg 4210 sigue intacto en la ranura 18.
Todo uberblock empieza por el mismo número mágico, 0x00bab10c, que se lee «oo-ba-bloc».
La figura sigue tres lugares del código de OpenZFS. Abre una nota Fuente para ver las líneas, tomadas de la versión zfs-2.4.4.
struct uberblock empieza por un número mágico y la versión del formato en disco. También guarda el txg, la hora de la sincronización y ub_rootbp, el puntero de bloque a los metadatos propios del
pool, del que cuelga el resto del árbol.
struct uberblock, uberblock_impl.h
uberblock
Extracto de include/sys/uberblock_impl.h, líneas
122–128, OpenZFS zfs-2.4.4.
Ver en GitHub
struct uberblock {
	uint64_t	ub_magic;	/* UBERBLOCK_MAGIC		*/
	uint64_t	ub_version;	/* SPA_VERSION			*/
	uint64_t	ub_txg;		/* txg of last sync		*/
	uint64_t	ub_guid_sum;	/* sum of all vdev guids	*/
	uint64_t	ub_timestamp;	/* UTC time of last sync	*/
blkptr_t ub_rootbp; /* MOS objset_phys_t */UBERBLOCK_MAGIC vale 0x00bab10c. Una ranura sin él no contiene un uberblock.
vdev_uberblock_sync elige la ranura: el txg módulo el número de ranuras. El txg aumenta en uno en
cada sincronización, así que los uberblocks dan la vuelta al anillo y el más reciente nunca cae sobre el
anterior.
vdev_uberblock_sync, vdev_label.c
vdev_uberblock_sync
Extracto de module/zfs/vdev_label.c, líneas
1782–1784, OpenZFS zfs-2.4.4.
Ver en GitHub
	int m = spa_multihost(vd->vdev_spa) ? MMP_BLOCKS_PER_LABEL : 0;
	int n = (ub->ub_txg - (RRSS_GET_STATE(ub) == RRSS_SCRATCH_VALID)) %
(VDEV_UBERBLOCK_COUNT(vd) - m);multihost=on, la última ranura se reserva para MMP y el anillo gira sobre una ranura menos.
VDEV_UBERBLOCK_COUNT es el anillo de 128 KiB dividido por el tamaño de una ranura: un sector, como mínimo 1 KiB y como máximo 8 KiB. El término RRSS_SCRATCH_VALID solo cuenta durante una expansión de RAID-Z. Después se escribe la misma ranura en cada una de las cuatro etiquetas.
Al importar, vdev_uberblock_load_done se ejecuta una vez por cada ranura leída. Ignora una ranura
cuya lectura ha fallado o cuyo número mágico es incorrecto, y se queda con el uberblock que gana la comparación.
vdev_uberblock_load_done, vdev_label.c
vdev_uberblock_load_done
Extracto de module/zfs/vdev_label.c, líneas
1547–1551, OpenZFS zfs-2.4.4.
Ver en GitHub
	if (zio->io_error == 0 && uberblock_verify(ub) == 0) {
		mutex_enter(&rio->io_lock);
		if (vdev_uberblock_compare(ub, &cbp->ubl_latest) > 0) {
			cbp->ubl_latest = *ub;
}vdev_uberblock_compare compara primero el txg y después la marca de tiempo.
La figura muestra un solo anillo. Un disco lleva cuatro etiquetas, dos al principio y dos al final, cada una con
su anillo, y cada txg escribe la misma ranura en las cuatro. Se suele decir que el anillo contiene 128
uberblocks. Solo es cierto con sectores de 512 bytes: ocupa 128 KiB, así que tiene 64 ranuras con ashift 11,
32 con ashift 12 y 16 a partir de ashift 13. Con multihost=on se reserva una ranura para MMP. Los
números de txg son inventados.
La mayoría de las salas explica una parte de ZFS con una figura y el código que hay detrás. Después del Vestíbulo y la historia de ZFS, la lista sigue a los datos, desde la raíz del pool hasta las funcionalidades construidas encima. Cada sala se puede leer por separado. La última, la sala de máquinas, cuenta cómo se hizo este sitio.
Dedicatoria
Mantener los datos a salvo es un trabajo crítico, y que rara vez se ve. A un sistema de archivos se le confía todo lo que la gente guarda, y tiene que seguir siendo correcto a pesar de las caídas, los discos que fallan y las escrituras interrumpidas. Uno de los principios sobre los que se diseñó ZFS, en palabras de Bill Moore: never, ever trust the underlying hardware.
(no confiar jamás, bajo ningún concepto, en el hardware subyacente; traducción nuestra)1
Este museo rinde homenaje a esa obra de ingeniería, y a las personas que la construyeron. Jeff Bonwick dirigió el desarrollo de ZFS, con Bill Moore como codirector;1 Matt Ahrens fue uno de sus dos autores originales.2 El trabajo comenzó en 2001 con dos ingenieros de Sun Microsystems3 y ZFS se integró en Solaris el 31 de octubre de 2005,4 un paso que Bonwick resumió así: 584 files, 92,000 lines of change, 56 patents, 5 years
(584 archivos, 92 000 líneas modificadas, 56 patentes, 5 años; traducción nuestra).4 El 17 de noviembre escribió: I’m incredibly proud of the ZFS team, and deeply grateful: no one person can do something on this scale.
(estoy increíblemente orgulloso del equipo de ZFS, y profundamente agradecido: nadie puede hacer por sí solo algo de esta envergadura; traducción nuestra)5
Rinde homenaje, también, a la ingeniería de Sun en aquellos años, en los que los ingenieros publicaban cómo funcionaban sus sistemas: el asignador slab, presentado por Jeff Bonwick en USENIX en 1994;6 DTrace, de Bryan Cantrill, Michael Shapiro y Adam Leventhal, en 2004;7 y el propio código fuente de ZFS, publicado bajo la CDDL como parte de OpenSolaris.3
Y a quienes lo mantienen vivo: OpenZFS, anunciado en 20132 y fundado por miembros de las comunidades de Linux, FreeBSD, Mac OS X e illumos.2 La versión que lee este museo recoge a más de 700 personas en su archivo AUTHORS.
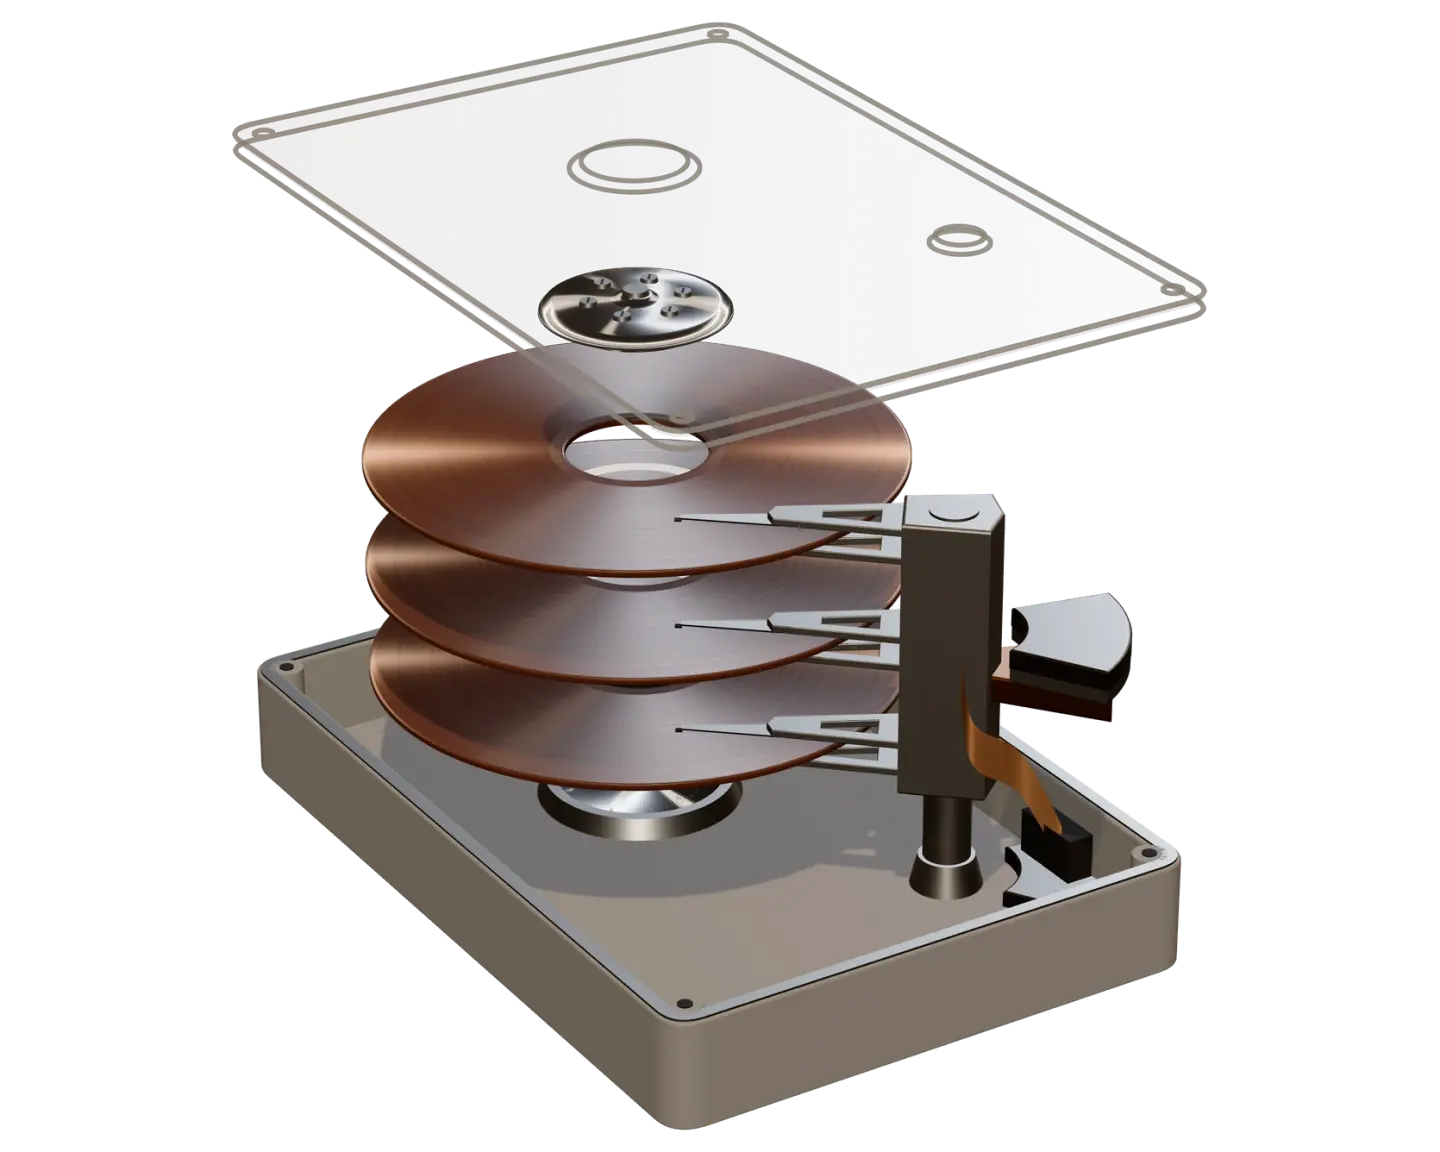
Fig. 2. El hardware subyacente: un disco duro de 3,5 pulgadas, despiezado a lo largo de su eje.
Texto de uberblok.storagebits.workers.dev tal como lo publicó, leído de su página y mostrado aquí con el formato de El Autómata. El original, en uberblok.storagebits.workers.dev · Volver a la noticia de El Autómata