Todos los periódicos y la radio, en unoEscrito por IA a partir de Hacker News · Cómo se hace
Hacker News
Inteligencia artificial · developer.nvidia.com
Servir GLM-5.3 a 607,8 tok/s con dos Nvidia DGX Station y vLLM
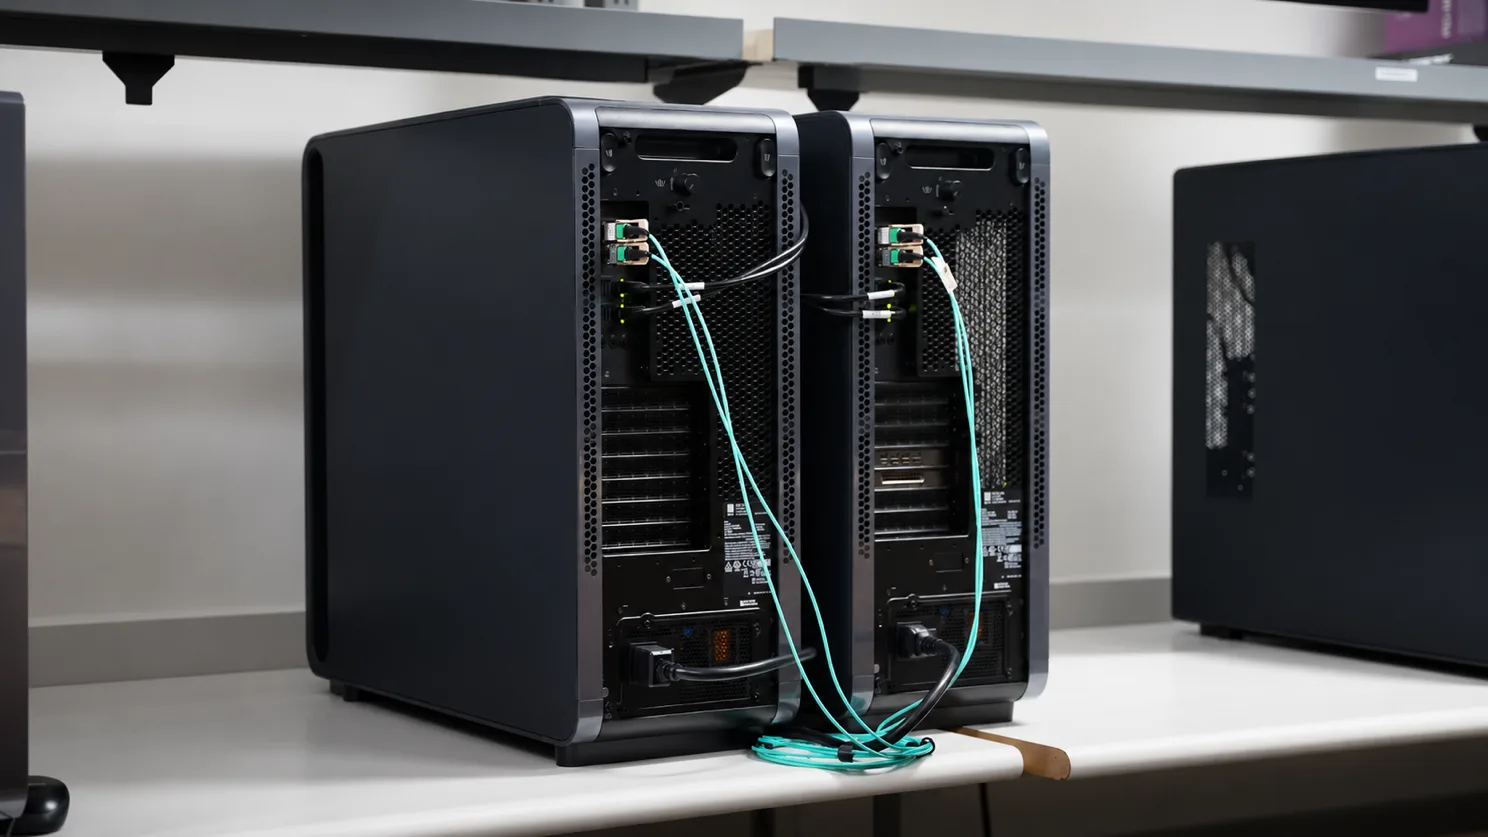
Nvidia explica cómo servir GLM-5.3, un modelo de 753.000 millones de parámetros, repartido entre dos DGX Station con GPU GB300 conectadas por RDMA. Con vLLM y paralelismo de tensores se obtiene un único endpoint compatible con la API de OpenAI, y el tutorial mide el comportamiento bajo carga concurrente.
Foto: vía developer.nvidia.com
1 medio · MadridPublicada 14 nov, 15:45Actualizada 14 nov, 21:05· Ya no está en portadaEscrita por IA · cómo funciona
El artículo parte de que un modelo de frontera local exige mantener todos sus pesos en la memoria de la GPU, y los mayores ya no caben en una sola máquina. La versión NVFP4 de GLM-5.3, cuantizada por Nvidia a partir del modelo mixture-of-experts de Z.ai, tiene 753.000 millones de parámetros, con 40.000 millones activos por token. La activación dispersa reduce el cómputo, pero todos los pesos deben seguir disponibles, porque cada token puede ir a expertos distintos. El checkpoint ocupa unos 464 GB, frente a los 252 GB de HBM3e de una sola GPU GB300.
La solución es conectar dos DGX Station con ConnectX-8 RDMA y aplicar tensor parallelism (TP=2): el modelo se reparte entre las dos GPUs, ambas calculan cada petición y la Station A (rank 0) devuelve la respuesta a través de una única API compatible con OpenAI. La Station B (rank 1) ejecuta solo un worker, sin servidor de API. El offload de pesos a CPU está desactivado, de modo que todo permanece en memoria de GPU.
El tutorial detalla los requisitos: dos DGX Station GB300 con Linux ya conectadas y validadas, acceso SSH y sudo con el mismo usuario, al menos 464 GB libres en cada una y aceptar las licencias del modelo. También hace falta una cuenta de Hugging Face con acceso al dataset cais/hle, del que se descargan los prompts de SPEED-Bench para el benchmark.
El primer paso es preparar las máquinas: elegir uno de los dos enlaces directos (cx8r0 o cx8r1), anotar su dispositivo RDMA y su IPv4, crear un fichero de entorno con esos valores y comprobar enlace de 400 Gb/s, MTU 9000, pings con jumbo frames y hora sincronizada. Después se descarga el checkpoint fijado por revisión en A, se copia con rsync a B y se verifica que ambas copias coinciden. El tercer paso lanza un rank de vLLM en cada Station con el mismo script, con un contexto máximo de 98.304 tokens.
«Serving GLM-5.3 at 607.8 tok/s across two Nvidia DGX stations with vLLM» · puesto 30 · 119 puntos · enviado por wondersky
Lo que dicen los comentarios
La conversación gira en torno al coste y a quién le sirve algo así. Se calcula que, con un precio de unos 100.000 dólares por Station, la amortización frente a una API de pago sería de siete años, y se responde que el valor está en la privacidad, el control y los entornos donde aprobar una API externa lleva años. Otros comparan con alternativas más baratas, como 8 GPU RTX Pro 6000, aunque se recuerda que el atractivo de las Station es que son equipos de sobremesa. Varios advierten del consumo, el ruido y de que 607 tok/s es el rendimiento agregado con 16 usuarios concurrentes (algo más de 35 tok/s por usuario; 107 tok/s con uno solo). También se discute por qué se eligió GLM y no DeepSeek, cuya arquitectura reduce la memoria por usuario, y se menciona lo que podría cambiar en 2027 con la memoria flash de alto ancho de banda.
Suponiendo 100.000 dólares por el DGX y 1,4 dólares por millón de tokens de salida de GLM-5.3, la amortización es de unos siete años a máxima utilización y sin contar la electricidad. Solo compensa si quieres privacidad o algo así.
Es útil en entornos controlados donde aprobar una API comercial llevará años. Puedo poner dos de estas estaciones en una oficina que maneje datos bancarios, médicos o secretos y que mis ingenieros dejen de quejarse.
El gráfico de tok/s frente a concurrencia está al final. Con un usuario se obtienen 107 tok/s, unas 2-3 veces lo que da un 4x DGX Spark. Los 607 tok/s son el total de 16 usuarios, algo más de 35 por usuario.
Para quien piense en esta configuración de más de 200.000 dólares para casa o una pequeña empresa: el consumo y el ruido son extremos, 1,6 kW cada una. Y 600 tokens/s con concurrencia 16 no es lo que se necesita.
Lo que ha hecho famoso a DeepSeek es reducir mucho la memoria por usuario, lo que permite más usuarios concurrentes en el mismo hardware y mucho más rendimiento total. Por eso es tan barato de alojar.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.