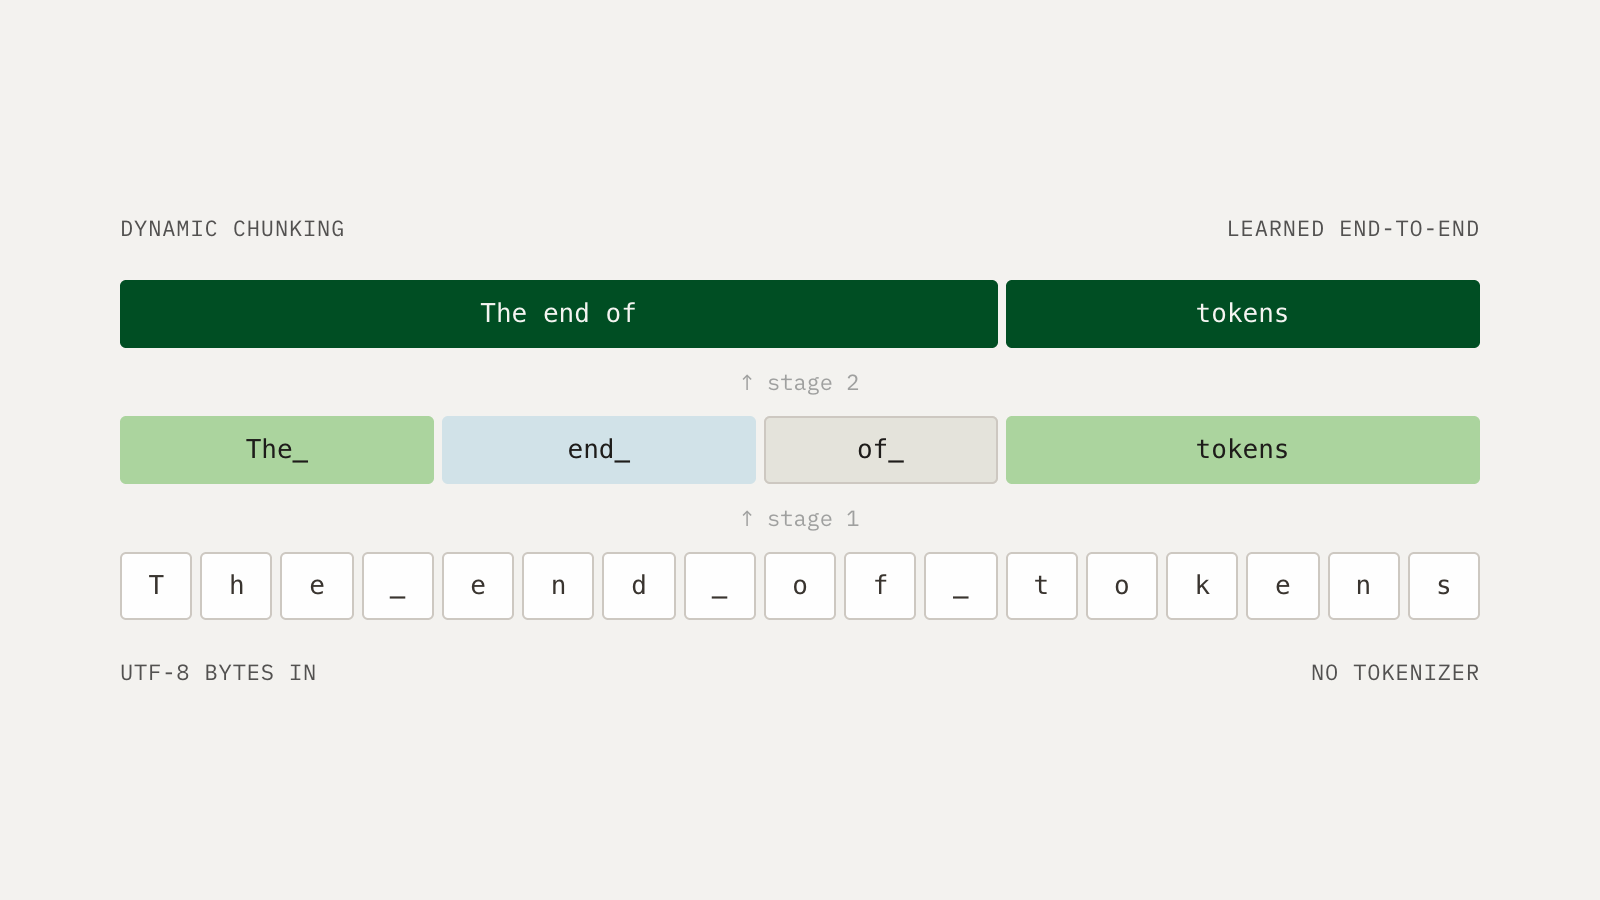
El artículo parte de la «lección amarga» de Richard Sutton: los métodos generales que aprovechan el cómputo y aprenden a escala, con los menores sesgos humanos posibles, son los que han impulsado el progreso. Cartesia sostiene que los modelos de lenguaje la siguen en gran parte, pero conservan pasos diseñados a mano, como los tokenizadores, que impiden aprender de extremo a extremo a partir de los datos en bruto. Por eso defiende que los modelos de lenguaje a nivel de byte son un paso fundamental.
Las redes jerárquicas (H-Nets), presentadas en 2025, funcionan así: un codificador lee las entradas (por ejemplo, bytes), un paso de troceado aprendido las comprime en pocos fragmentos, una red principal trabaja sobre esos fragmentos (análogos a los tokens), se descomprimen a la resolución original sumándolos con una conexión residual y un decodificador termina el procesamiento. Un H-Net de una etapa hace un nivel de troceado dinámico, y la red principal puede ser a su vez un H-Net, con lo que el troceado se anida de forma recursiva. Según Cartesia, a diferencia de los modelos con tokenizador, que lo hacen offline y en varias fases de entrenamiento, aquí el troceado se hace de extremo a extremo.
La tokenización habitual, Byte Pair Encoding (BPE), parte de los 256 valores de byte y fusiona repetidamente el par adyacente más frecuente de un corpus fijo hasta alcanzar un tamaño de vocabulario (128k en Llama-3). En la mezcla de datos de Cartesia, cada token BPE cubre unos 4,57 bytes de media. La compresión, apunta el artículo, es fija y es una de las últimas partes del proceso que se diseñan a mano en lugar de aprenderse.
Para validar una versión mejorada de los H-Nets, que Cartesia planea publicar, construyeron una escalera de escalado moderna: entrenaron una mezcla de datos común para comparar bytes y BPE en igualdad de condiciones, incluido un tokenizador BPE reentrenado para la línea base, y escalaron un Transformer con BPE según las prácticas habituales. Después convirtieron cada peldaño en un H-Net a nivel de byte, reutilizando la arquitectura troncal y los hiperparámetros. Los resultados que cita incluyen una mejora de 1,3x en pérdida de validación, de 2x en código y de 2x fuera de distribución.
La serie anuncia además un H-Net de dos etapas que, según Cartesia, supera a un modelo open source equivalente con 10 veces menos cómputo y datos, un análisis de comportamientos nuevos como la tokenización en contexto y líneas de investigación en biología y visión. La segunda entrega explorará por qué los H-Nets son tan eficientes.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.