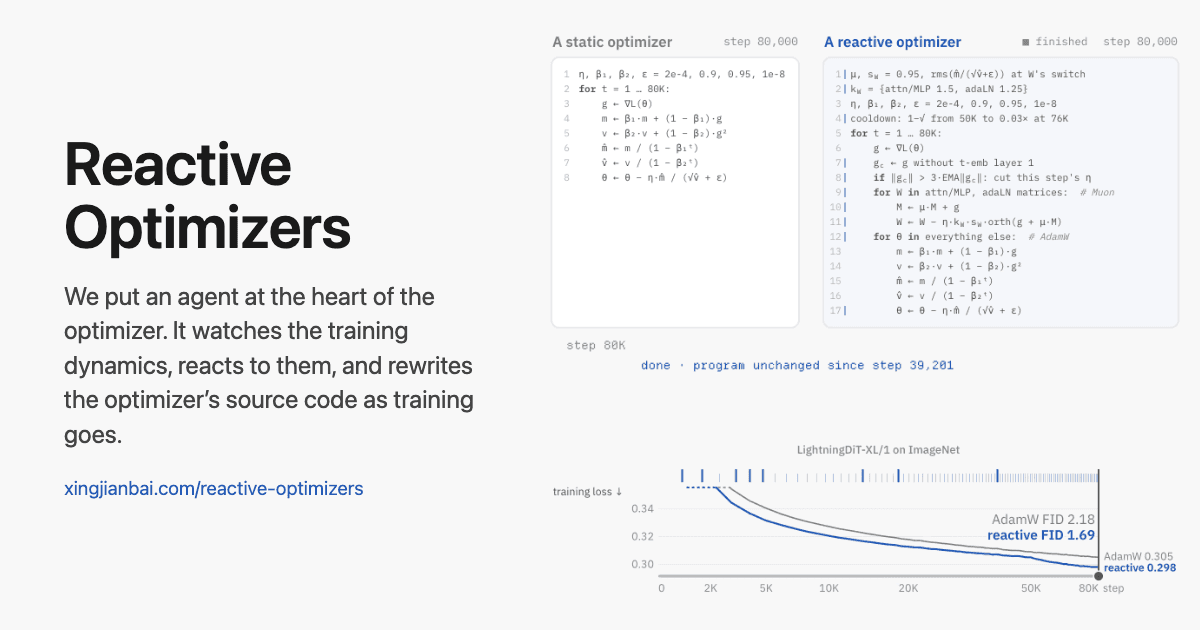
Xingjian Bai, Jia-Hao Liang, Jayden Teoh y Vincent Sitzmann parten de que la receta para optimizar una red neuronal suele fijarse antes de empezar: tasas de aprendizaje adaptativas, preacondicionamiento, actualizaciones ortogonalizadas, calendarios ligados al paso de entrenamiento. Incluso los optimizadores descubiertos automáticamente se ejecutan sin cambios hasta el final. Su propuesta, llamada OPAL (OPtimizer with an Agent in the Loop), deja que un agente razone durante el entrenamiento y escriba la regla de actualización de pesos de cada grupo de parámetros. Es zero-shot: no aprende ni conserva nada de ejecuciones anteriores, y todo el algoritmo del optimizador puede reescribirse.
El caso de uso que plantean es el de quien tiene una sola GPU, un día y un presupuesto limitado de tokens de API, y solo puede hacer un entrenamiento serio. El optimizador reactivo gasta tokens de LLM en lugar de horas de GPU o de investigador. Los autores creen que será más útil donde aún no existe receta, como con una arquitectura o un dataset nuevos.
Los resultados se obtuvieron con Claude Opus 5.5 como agente. En la pista de optimización de modded-nanogpt (un GPT de 162M entrenado con FineWeb) crearon dos variantes sin receta ajustada: otros idiomas (chino, tailandés y kirguís) y un cuarto del tamaño de batch. Frente a cinco recetas del leaderboard, OPAL iguala o supera a la mejor base en todos los casos. En Goldfish, con un GPT de 125M en amhárico, la receta oficial termina en 83,48 bits por frase y OPAL, partiendo de ella, en 81,11. Un barrido de la tasa de aprendizaje da 80,89, y OPAL inicializado desde esa receta llega a 80,73.
En generación de imágenes, OPAL supera a la receta oficial en LightningDiT-XL/1 (FID-50K de 1,83 frente a 2,18 con guidance, y 4,33 frente a 5,15 sin él) y en RAEv2-B (3,19 frente a 3,39). El texto añade que el agente ideó por su cuenta calendarios sofisticados y estrategias para evitar picos de pérdida y escapar del sobreajuste, y analiza el coste y la aplicabilidad a escala. Hay un paquete para probarlo en entrenamientos propios.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.