Todos los periódicos y la radio, en unoEscrito por IA a partir de Hacker News · Cómo se hace
Hacker News
Inteligencia artificial · divagr.com
Qwenputer: una CPU RISC-V determinista y funcional dentro de Qwen3.5
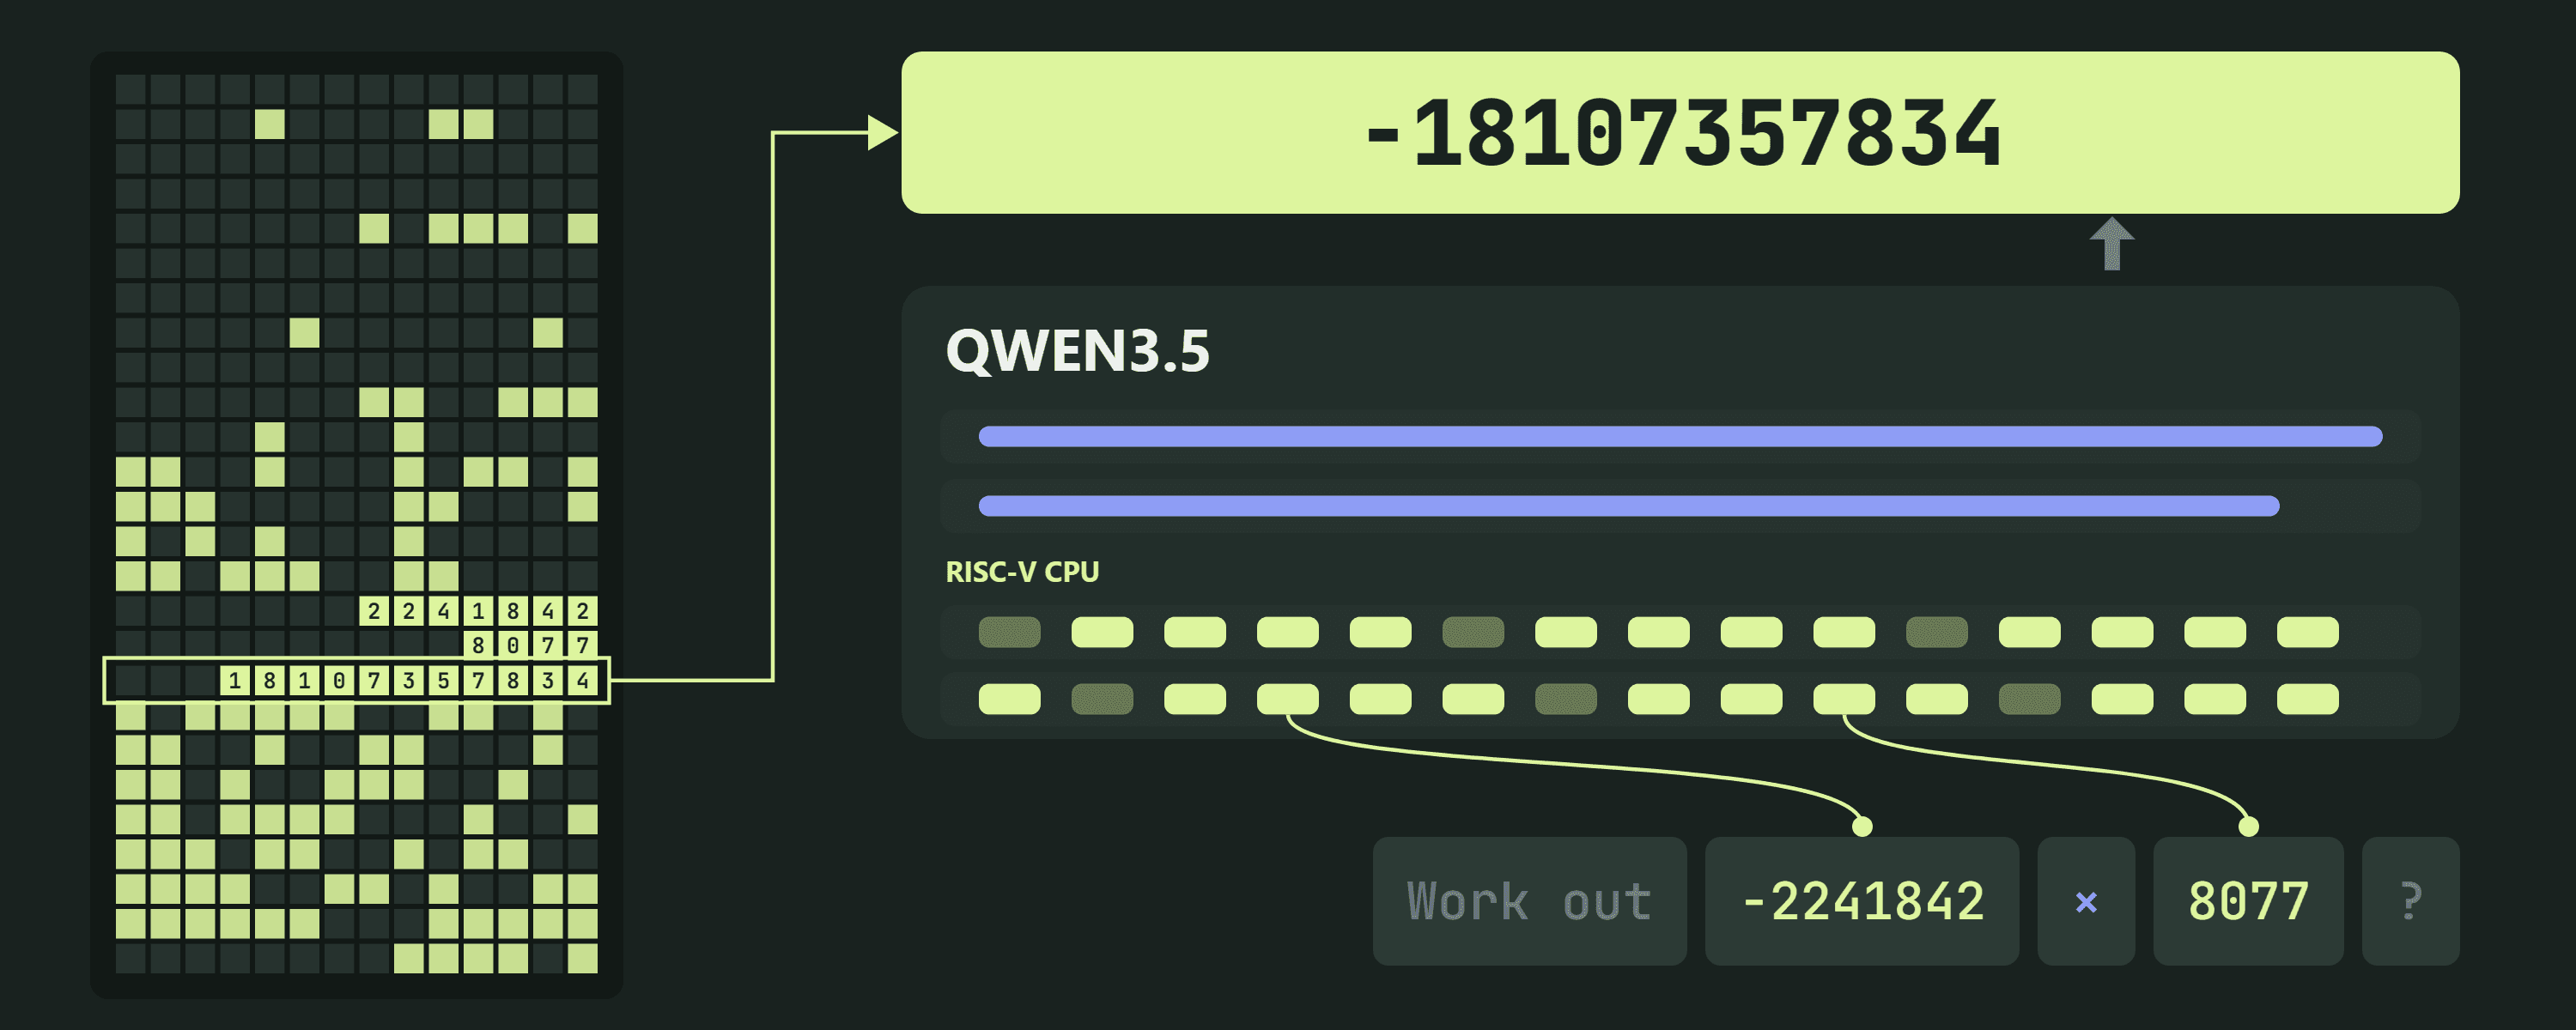
Un desarrollador ha compilado una CPU RISC-V de 32 bits en los pesos de un Qwen 3.5 4B sin modificar, y usa las capas Gated DeltaNet del propio modelo como RAM. Ejecuta aritmética, C y MicroPython dentro de los forward passes, sin herramientas ni runtime externos.
Foto: vía divagr.com
1 medio · MadridPublicada 29 oct, 02:15Actualizada 29 oct, 12:50· Ya no está en portadaEscrita por IA · cómo funciona
Qwenputer parte de un Qwen 3.5 4B estándar al que se añade una CPU embebida en los pesos. Aprovecha que tres de cada cuatro capas de atención de Qwen 3.5 usan Gated DeltaNet, una RNN lineal con una matriz de estado por cabeza. Si se fija el gate a 1, la intensidad de escritura (beta) a 1 y se usan claves one-hot, cada escritura sobrescribe exactamente una fila y cada consulta devuelve un valor exacto: el estado funciona como RAM direccionable, con un tamaño que no crece con la conversación, a diferencia de la KV cache.
No hay entrenamiento: un compilador fija cada peso directamente a partir de la descripción de la CPU como circuito. La CPU es un núcleo RV32IM con la extensión Zba y una pequeña unidad bignum; ocupa 11 capas por delante de las 32 de Qwen y los pesos originales quedan intactos, con los nuevos añadidos en dimensiones y capas extra. Pasa los riscv-tests oficiales, sus programas coinciden con qemu y ha ejecutado 18 millones de instrucciones sin un solo error. Cada instrucción se traduce en unos pocos tokens (dirección, valor y un token STEP). Qwen envía las instrucciones y lee el resultado aprovechando el formato de tool calls, sin que haya llamadas externas.
En los benchmarks, Qwenputer obtiene un 97,5 % en div_big, mul_big y add_or_sub_big, y un 100 % en mul_div_multiple_longer, frente al 72,5 %, 55 %, 87,5 % y 90 % del Qwen base. En la aritmética de enteros largos de NUPA pasa del 48,6 % al 100 %, igual que dándole una herramienta de Python. Tras comparar unas 230.000 posiciones de salida con una máquina de referencia no hubo discrepancias, y el texto normal del modelo apenas cambia (KL de 6e-4, con un suelo de ruido de 5e-4).
El autor añade además un sistema de ficheros experimental, también en el estado DeltaNet: un directorio de 1.024 ranuras, hasta 512 ficheros y unos 53.000 tokens de texto, persistente si se guarda el estado entre conversaciones. Con él, Qwen acierta el 90 % de los hechos que cambiaron entre chats, frente al 30 % al pegar los chats antiguos. Entre las limitaciones, el checkpoint pesa 18,8 GB (el doble que el base, en buena parte relleno de ceros), necesita un driver llamado RvChat y no funciona con un generate() normal. Es lento: unos 3.200 tokens de CPU por segundo en una L4.
«Qwenputer: A functioning, deterministic RISC-V CPU inside Qwen3.5» · puesto 20 · 664 puntos · enviado por csmantle
Lo que dicen los comentarios
Entre los comentarios predomina el humor y el asombro: bromas sobre agentes desalineados, sobre una instrucción HCF y sobre ejecutar DOOM. Hay quien pregunta si no sería más eficiente integrar un ordenador con un LLM de otra manera, y otro lector propone añadir capas congeladas de cálculo a los modelos, o entrenar desde cero con estos circuitos. Se enlazan trabajos parecidos, como Percepta (wasm dentro de un transformer) y Loom, que según su autor necesita muchas menos capas y corre Doom muy despacio. Una duda técnica es que el aprendizaje continuo podría sobrescribir la CPU. También hay un debate lateral sobre lo difícil que es aprender cómo funcionan los LLM.
¿No se puede usar un ordenador como ordenador sin todo este rodeo? Si quieres integrar un LLM con cálculo duro, seguramente hay una forma más eficiente. ¿O esto va hacia el «¿pero corre DOOM?»?
Creo que la esperanza es lograr una mejor integración de la calculadora en el modelo, como el cálculo mental frente a la calculadora: es mucho más fluido en el razonamiento si lo dominas.
Siempre me he preguntado por qué no añadimos a los modelos unas pocas capas congeladas de cálculo complejo a dos tercios de profundidad: FFT dirigibles y operaciones vectoriales que el modelo aprenda a usar durante el entrenamiento.
Aprender lo básico de cómo funcionan los LLM se puede hacer en un fin de semana si has aprobado álgebra lineal. Su estructura es sencillísima: la inteligencia está en la enorme cantidad de datos.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.