El autor cuenta un caso visto en producción: recovery_prefetch, que actúa en segundo plano en las réplicas, puede causar cortes. Recuerda dos avisos antiguos en la lista de Postgres. En 2021, Stephen Frost advertía de prefetches innecesarios con full page writes (FPW) activados. En 2025, Michael Zhilin (Postgres Pro) describió una réplica física con horas de retraso, resuelta al desactivar recovery_prefetch tras analizar perf y strace: el código no tiene en cuenta que un bloque puede cargarse desde una imagen de página completa del WAL y no desde disco, y aun así llama a fadvise.
A ello suma un tercer factor que, según dice, no se había diagnosticado: cuando el primario hace E/S secuencial grande, recovery_prefetch la convierte en lecturas aleatorias de 8 KB. Para los mismos bytes leídos, las IOPS de las réplicas pueden multiplicarse hasta por 16 y agotar las disponibles, de modo que la réplica se retrasa mucho tras una ráfaga de escrituras. Señala que las FPW y la replicación síncrona están muy extendidas en producción.
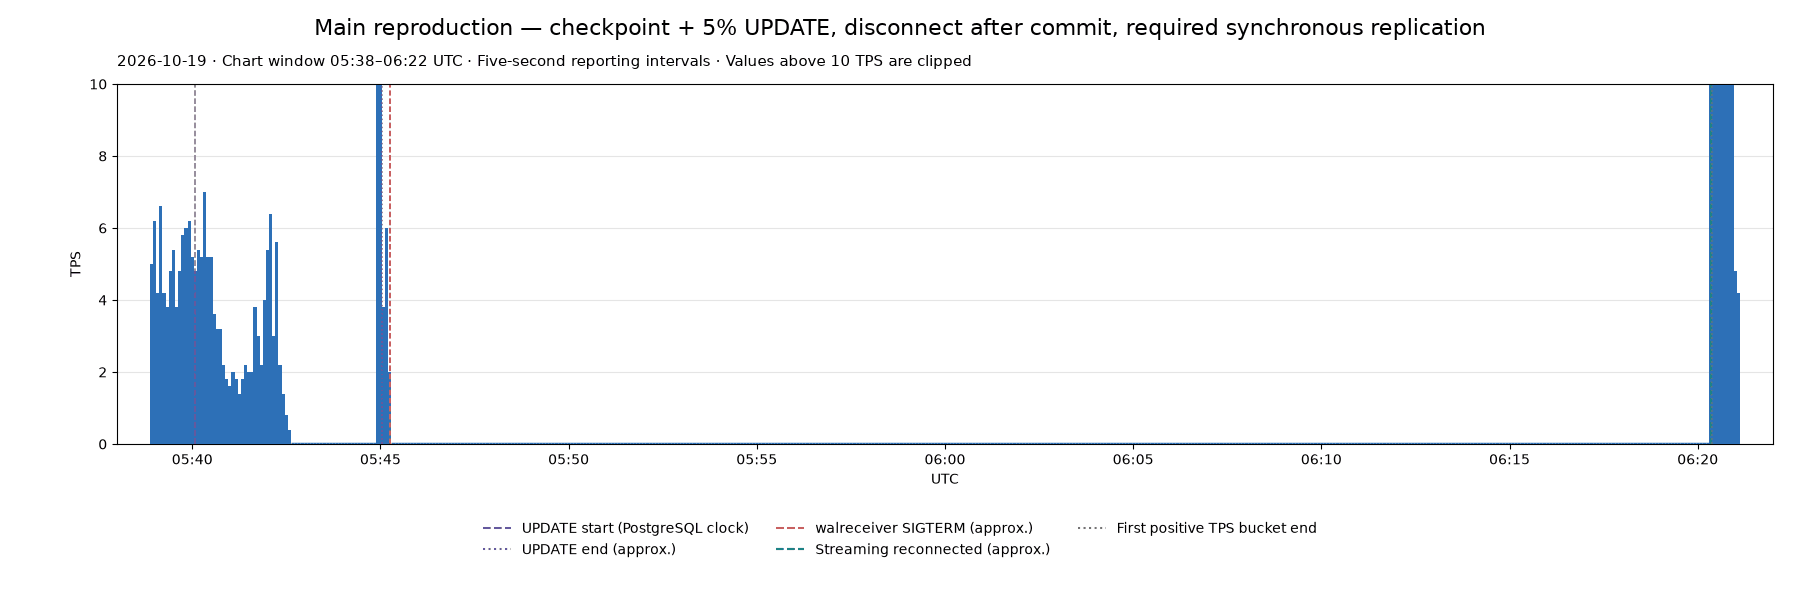
El bloqueo se explica por la máquina de estados de las réplicas (xlogrecovery.c): si la réplica pasa a restaurar WAL, no vuelve a streaming hasta ponerse al día. Con replicación síncrona, el primario no puede aceptar escrituras sin una réplica sana. El experimento usa un servidor pequeño (disco de 500 IOPS, 2 CPU, 8 GB), pgbench con escala 640 (unos 10 GB) y 5 TPS fijos, un UPDATE sobre el 5 % de pgbench_accounts y la muerte del proceso walreceiver. Los TPS caen a cero y las escrituras se cuelgan más de 30 minutos, o horas con tablas mayores. El autor añade que un VACUUM también puede generar esa ráfaga de escrituras.
Con recovery_prefetch desactivado (y las FPW activas), no hay ráfaga de lecturas, la réplica sigue al día y aplica el UPDATE en menos de diez minutos. El autor se inclina por desactivar el ajuste en general, porque ve dudosos sus beneficios con FPW, y propone usar dos réplicas con quorum commit (ANY 1) para ganar robustez, aunque cueste más. El código de reproducción está en GitHub.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.