Todos los periódicos y la radio, en unoEscrito por IA a partir de Hacker News · Cómo se hace
Hacker News
Inteligencia artificial · ubicloud.com
Mejorar la precisión de las llamadas a herramientas en vLLM
Ubicloud explica por qué servir modelos de pesos abiertos con vLLM produce llamadas a herramientas que incumplen su esquema, y cómo la decodificación restringida lo corrige. Con Kimi K2.6 en vLLM 0.28, solo el 92 % de las llamadas era válido; con la opción nueva de vLLM 0.31, el 100 %.
Foto: vía ubicloud.com
1 medio · MadridPublicada 26 oct, 14:40Actualizada 26 oct, 16:55· Ya no está en portadaEscrita por IA · cómo funciona
Los autores sostienen que la precisión de las llamadas a herramientas es clave al servir modelos de pesos abiertos. Si una llamada no es correcta, el modelo sigue construyendo sobre un contexto sin sentido, algo especialmente grave en cargas agénticas con sesiones de varios turnos. Con Kimi K2.6 en vLLM 0.28 obtuvieron el esquema esperado solo el 92 % de las veces: 2 de cada 25 llamadas fallaban.
El artículo repasa cómo funciona el proceso. El arnés (por ejemplo, OpenCode) envía al modelo un array JSON con las herramientas disponibles y sus esquemas: parámetros, tipos y campos obligatorios. El motor de inferencia lo envuelve en tokens específicos del modelo, y un parser del servidor convierte la salida del modelo en un objeto JSON con las llamadas, que el arnés ejecuta.
Dejar que el modelo genere las llamadas libremente funciona casi siempre, pero no siempre, y los fallos contaminan la ventana de contexto con mensajes de error, bajan la calidad y encarecen el uso por los reintentos. Para comprobarlo, Moonshot AI publicó el benchmark K2VV ToolCall, con 2000 peticiones y dos métricas: similitud de disparo (cuándo se decide llamar a una herramienta) y precisión de esquema. Los autores atribuyen los fallos a la naturaleza probabilística del modelo, que puede inventar nombres vistos en el entrenamiento, como search_web en lugar de web_search o city_name en lugar de location.
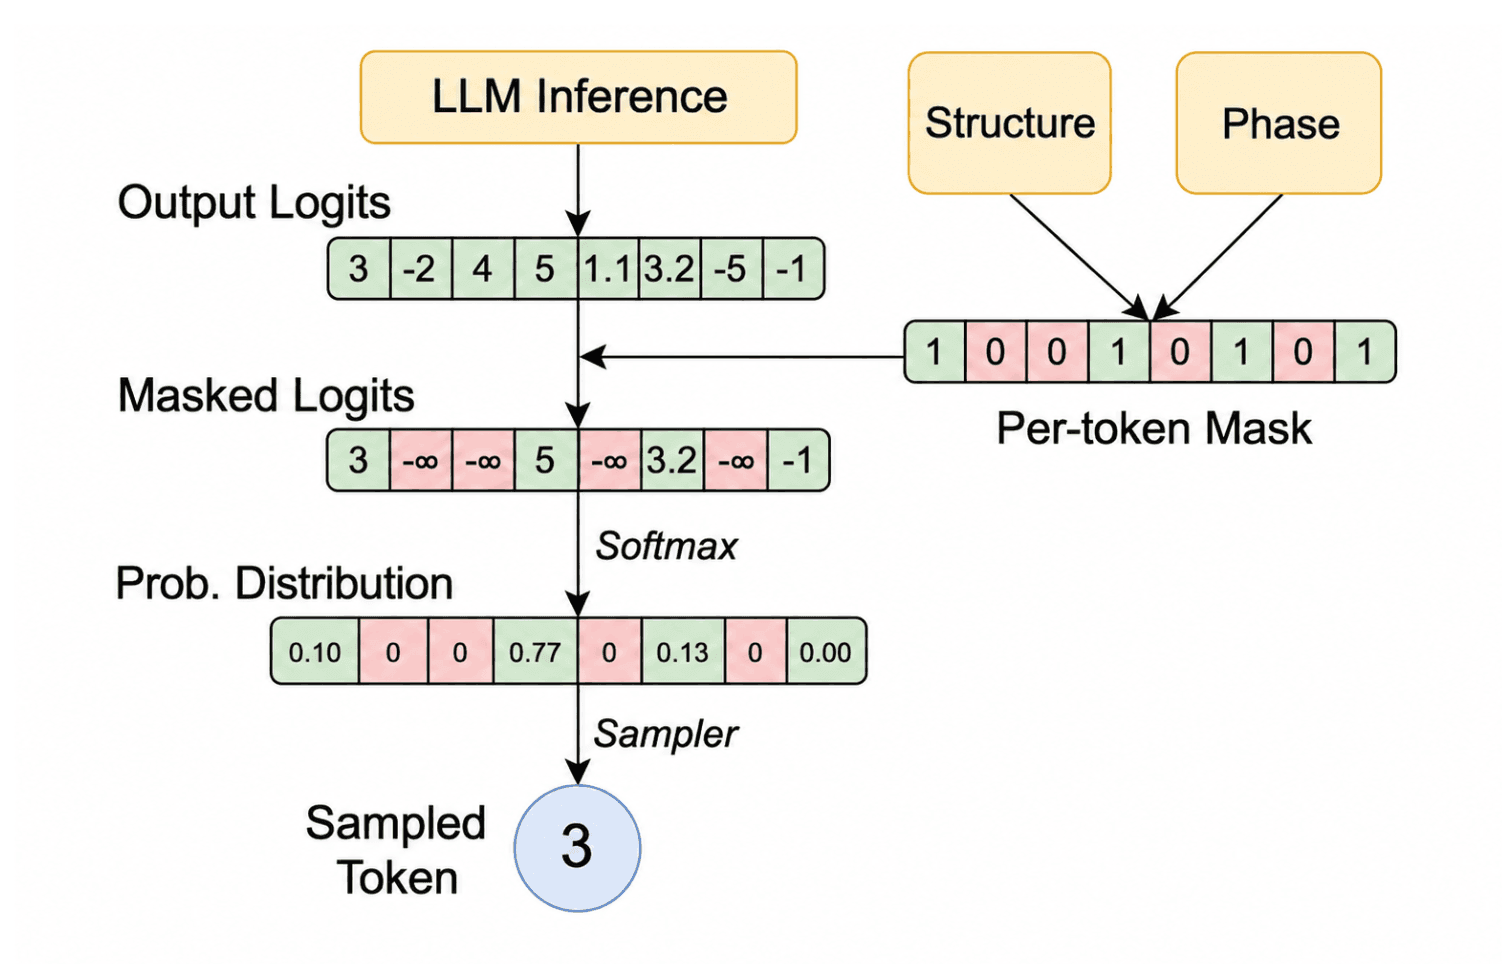
La solución es la decodificación restringida: el motor guía la generación paso a paso y solo permite los tokens válidos según el esquema. vLLM la implementa con las structural tags de la librería XGrammar, que definen el recorrido válido de una llamada (inicio, nombre, índice, inicio de argumentos, JSON restringido por esquema, fin) y enmascaran los tokens inválidos. Así, la precisión de esquema pasa de ser un esfuerzo del modelo a una garantía en tiempo de ejecución, con una sobrecarga que los autores califican de insignificante. Se activa con una opción del servidor desde vLLM 0.31 y, según el artículo, da el 100 % con los modelos Kimi y DeepSeek más recientes.
«Fixing Tool-Call Accuracy in vLLM» · puesto 30 · 161 puntos · enviado por coffeemug
Lo que dicen los comentarios
Buena parte de la conversación matiza el titular. Un comentarista señala que la decodificación restringida lleva tiempo en vLLM y que Ubicloud sobre todo tuvo que configurarlo bien, aunque uno de los autores responde que para Kimi hicieron falta cambios de código que luego se integraron en vLLM, y que hoy basta con el flag `--tool-strict-level`. Otros recuerdan que llama.cpp ya lo hacía desde hace tiempo. Se discute también si restringir la salida degrada la calidad frente a reintentar la llamada entera, y quien conoce el sistema responde que solo interviene cuando el modelo intenta un token que violaría el esquema. Aparecen además dudas sobre la herramienta en entornos reales, su extensión a código sintácticamente correcto y el origen de la sintaxis <||>.
La decodificación restringida lleva mucho tiempo en vLLM. El artículo confunde, porque parece que arreglaron vLLM cuando en realidad solo había que configurarlo bien. Aun así, tener benchmarks para detectar regresiones merece reconocimiento.
Arreglamos vLLM en el sentido de que el comportamiento correcto para Kimi exigía cambios de código; era imposible con configuración. Ahora, con la última versión, basta con poner `--tool-strict-level` en `parameter`.
Me gustaría ver el impacto real en la calidad del modelo. La decodificación con esquema cambia la distribución de salida. Un método de retroceder y reintentar tampoco contamina el contexto y también daría un 100 % de acierto.
La decodificación restringida solo interviene si el modelo intenta emitir un token que violaría el esquema. Con la llamada bien definida, no veo por qué reduciría la calidad frente a reintentar hasta acertar.
Si lo entiendo bien, las llamadas no las hace el modelo como tal: el motor de inferencia filtra todas las opciones y deja solo los movimientos válidos. ¿Podría usarse algo así en otros contextos?
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.