Todos los periódicos y la radio, en unoEscrito por IA a partir de Hacker News · Cómo se hace
Hacker News
Ciencia · e-means.github.io
E-means: superar a k-means con una décima parte de las épocas
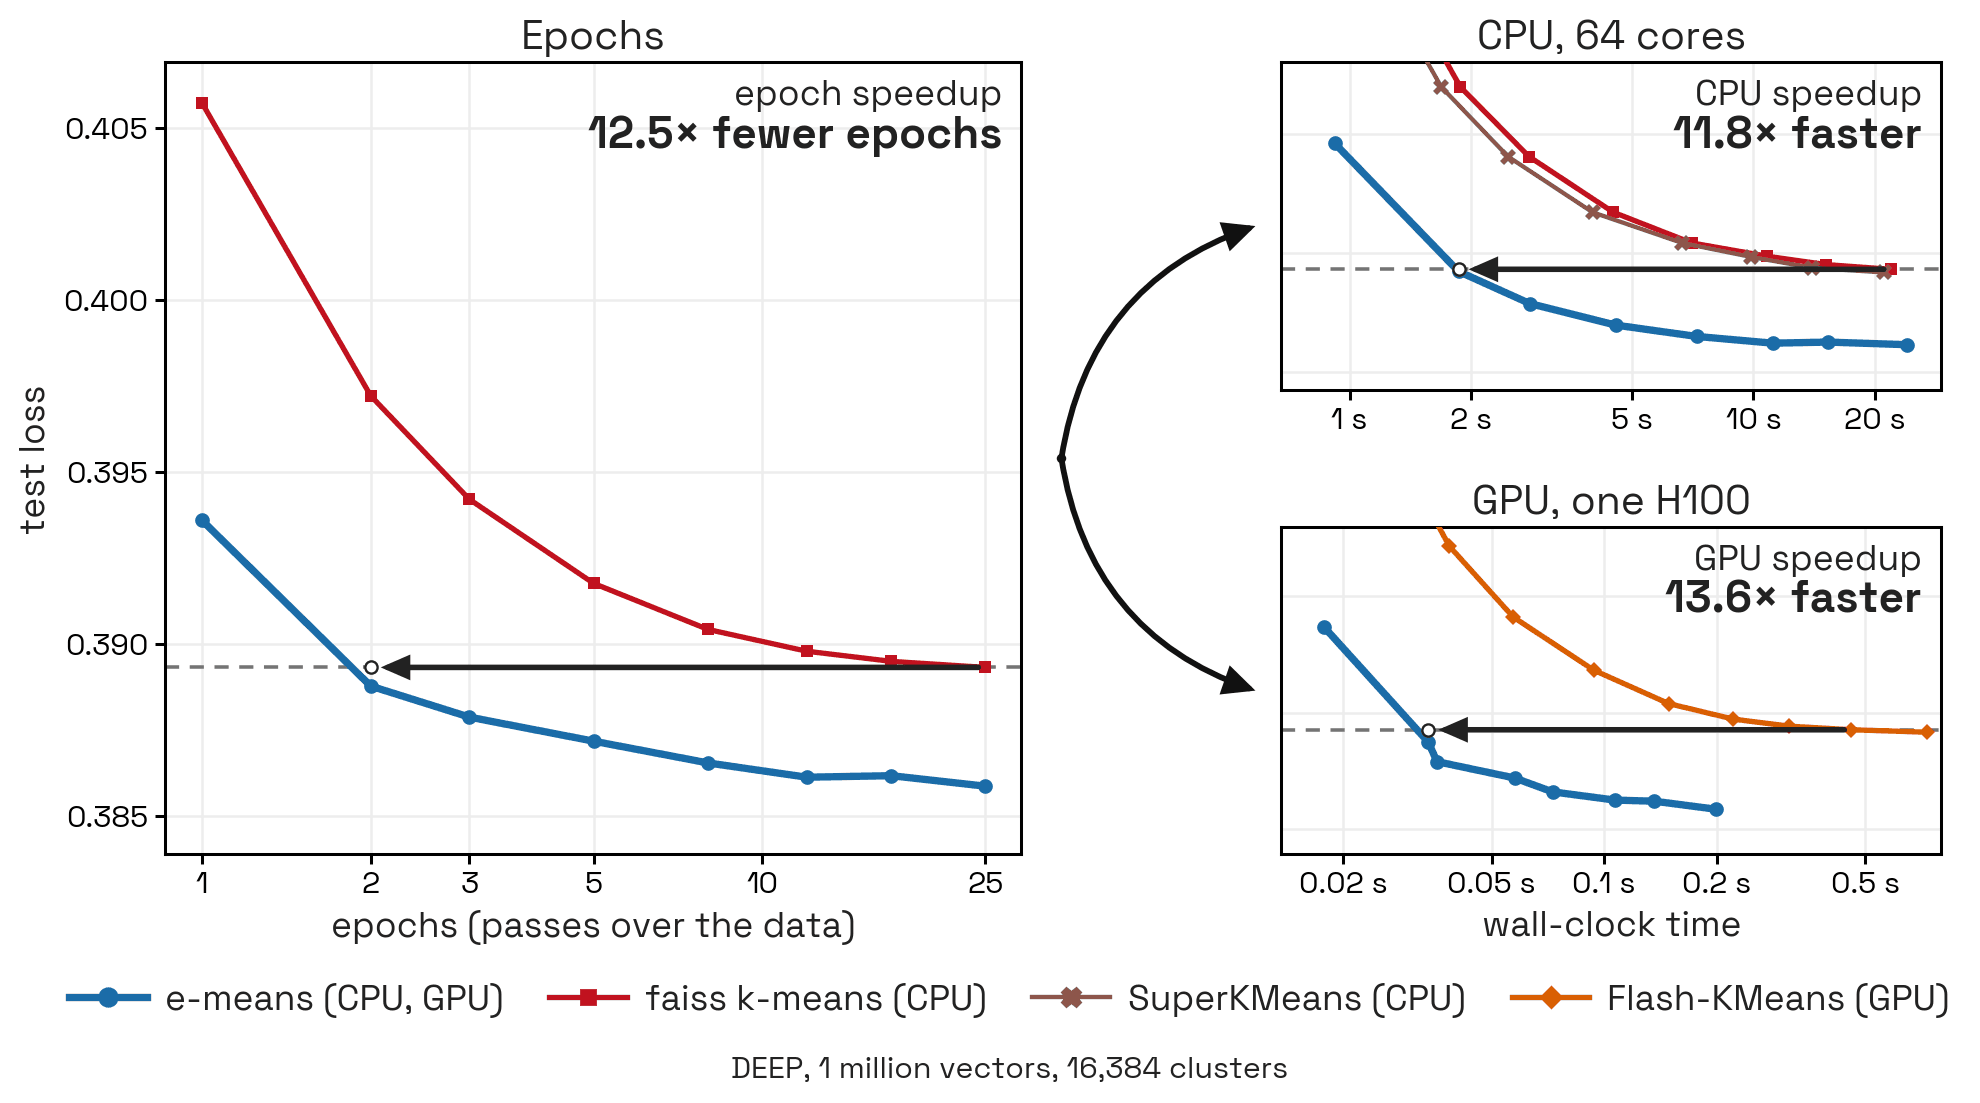
E-means es un algoritmo de k-means por mini-lotes que actualiza los centroides con medias móviles exponenciales y fija solo sus hiperparámetros mediante leyes de escala. Según sus autores, alcanza en 1,2-3 épocas la pérdida que Lloyd logra en 25, con aceleraciones de 10-45× en GPU y 8-15× en CPU.
Foto: vía e-means.github.io
1 medio · MadridPublicada 9 nov, 20:45Actualizada 10 nov, 14:20· Ya no está en portadaEscrita por IA · cómo funciona
El problema de k-means consiste en encontrar k centroides que minimicen el error cuadrático medio entre cada punto y su centroide más cercano. El algoritmo de Lloyd, el estándar, usa todo el conjunto de datos en cada iteración, normalmente entre 20 y 50. Los métodos de mini-lotes existentes se basan en su mayoría en la regla de MacQueen, de 1967, que acumula estadísticas sin descartarlas nunca.
E-means mantiene para cada cluster una suma y un recuento, y el centroide es su cociente, pero los actualiza con una media móvil exponencial: las asignaciones antiguas se olvidan a un ritmo α. Añade una inicialización y una estrategia de reactivación de clusters muertos (partiendo en dos un cluster grande) mejoradas, un decaimiento de α con planificación en coseno y una fase final que deja cada centroide en la media exacta de la última época. El tamaño de lote y el paso se fijan solos con leyes de escala, sin ajuste manual. Hay además kernels de GPU que fusionan la asignación al centroide más cercano.
El autor explica por qué eligió medias móviles y no descenso de gradiente. El proyecto parte de un trabajo previo en Meta FAIR de Hugo Touvron y Hervé Jégou, que había visto que k-means por mini-lotes con descenso de gradiente podía batir a Lloyd. Con pasos grandes, sin embargo, el gradiente se vuelve inestable. El autor sospecha que la media móvil garantiza que el centroide quede siempre dentro de la envoltura convexa de sus puntos, y el gradiente puede pasarse. En el mejor ajuste, el gradiente queda un 1,6 % (DEEP) y un 0,4 % (SIFT) por encima.
Lloyd resulta ser un caso particular de e-means: lote completo y α = 1, sin planificación. El estudio de hiperparámetros muestra que esa esquina queda lejos de la región de menor pérdida, lo que, según el artículo, explica la ventaja. En conjuntos de juguete con 200 semillas, e-means cae menos en configuraciones patológicas; por ejemplo, 3,5 % de los arranques frente al 26 % de Lloyd en el caso de dos blobs de tamaños muy distintos.
«E-means: Outperforming k-means in one-tenth the epochs» · puesto 29 · 483 puntos · enviado por porridgeraisin
Lo que dicen los comentarios
Varios usuarios cuentan que lo han probado en sus propios proyectos, con resultados desiguales: aceleraciones notables en índices vectoriales y ninguna ventaja cuando no hay un conjunto de datos que muestrear. El autor del trabajo, Swann Bessa, responde en el hilo. La crítica más seria llega de saagarjha, que cree que la novedad es limitada y que no se mide cómo escala con más datos o paralelismo; oofbey añade que faltan comparaciones con un k-means por mini-lotes bien ajustado, como el de scikit. Aparecen también un paralelismo con el recocido simulado y una discusión sobre cómo elegir k, que sigue sin tener respuesta clara.
En una malla icosaédrica sobre una esfera no mejora: cada centroide se calcula directamente desde la geometría, y los mini-lotes solo lo cambian por una estimación ruidosa. Fue mucho más lento y dejó la malla ruidosa.
Con 500k embeddings de LAION y 4.096 celdas, e-means fue unas 4 veces más rápido que 5 iteraciones de Lloyd, con algo más de recall y celdas más homogéneas. Con 2 iteraciones fue unas 10 veces más rápido.
No es especialmente nuevo: se hace k-means por mini-lotes con actualización EWA desde hace tiempo. Ganar a Lloyd es una vara baja, y lo importante sería cómo escala con más datos o paralelismo, donde la comunicación limita.
Casi todos los trucos ya estaban establecidos y las ablaciones no muestran sinergia especial. Comparar con faiss es justo, pero deberían incluir un k-means por mini-lotes bien ajustado, como el de scikit.
Para elegir k se usa el método del codo, pero no hay una forma realmente buena, porque el clustering es en parte subjetivo. Métodos como HDBSCAN encuentran solos el número de clusters, aunque conservan otro parámetro clave.
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.