Todos los periódicos y la radio, en unoEscrito por IA a partir de Hacker News · Cómo se hace
Hacker News
Inteligencia artificial · haddyalchaer.com
Tras 600 experimentos, esto es lo que descubrí sobre los modelos del mundo JEPA
Haddy Alchaer relata 600 experimentos con LeWM, un modelo del mundo tipo JEPA, en la prueba Push-T. Sin reentrenar el modelo, mejora su planificación a largo plazo del 22 % al 85 % y cuestiona lo exigente que es el test estándar.
Foto: vía haddyalchaer.com
1 medio · MadridPublicada 13 nov, 19:35Actualizada 13 nov, 21:15· Ya no está en portadaEscrita por IA · cómo funciona
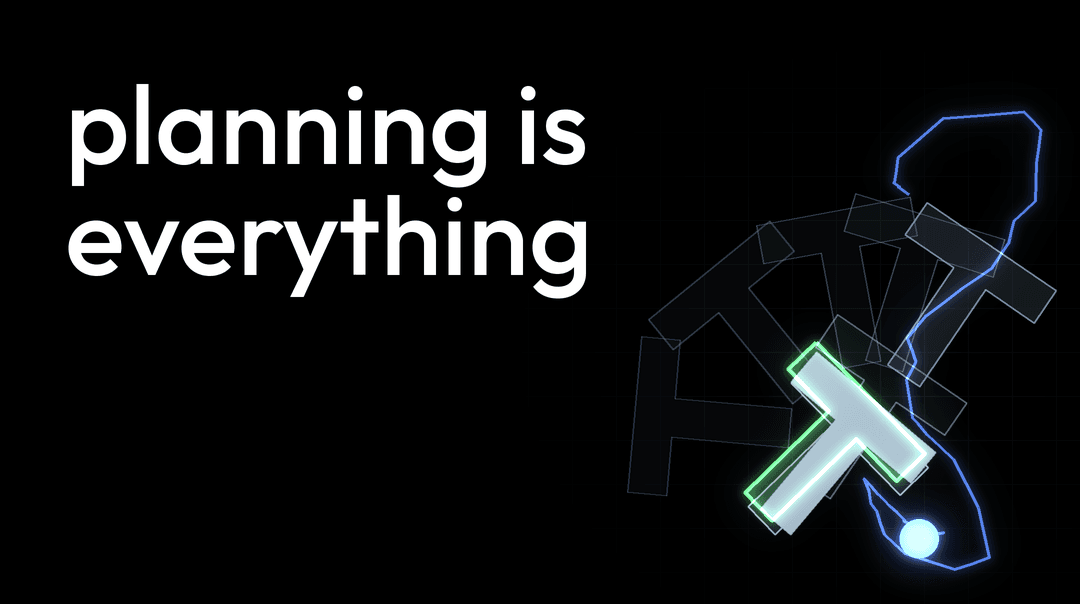
El autor parte de la arquitectura JEPA (joint-embedding predictive architecture), defendida por Yann LeCun frente a los modelos generativos que predicen píxeles. Consta de un encoder que convierte cada fotograma en un embedding, un predictor que estima el embedding siguiente dada una acción y un planner que prueba cientos de secuencias de acciones y elige la que acaba más cerca del embedding del objetivo. Todo ocurre en el espacio de embeddings. Trabaja sobre LeWM, un JEPA publicado este año por un equipo que incluye a LeCun, cuyo banco de pruebas principal es Push-T: un robot empuja un bloque con forma de T hasta una posición objetivo.
Primero comprueba si el predictor limita al modelo. En tareas con el objetivo a 75 pasos y subobjetivos tomados de una demostración experta, LeWM acierta el 78 % de las veces y la versión con la física exacta del simulador, el 77 %. Es decir, las predicciones ya son tan buenas como la física perfecta, y las mejoras han de venir de cómo se usa el modelo. Sin reentrenarlo, el autor propone cuatro métodos de planificación nuevos.
El primero encadena búsquedas con un subobjetivo cada 25 pasos, el horizonte en el que LeWM es preciso (89,7 % de éxito a 25 pasos, frente al 22 % a 75 pasos de golpe). Con ello sube al 80 %, frente al 42 % que logra la física exacta sin subobjetivos. El segundo construye un grafo de memoria con unos 460.000 estados embebidos de las demostraciones, con un coste por cada salto entre demostraciones distintas; así llega al 85 % sin subobjetivos expertos, la misma cifra que con ellos. Ordenar con la distancia de embeddings qué subobjetivo es alcanzable acierta el 87 % de las veces.
El autor advierte de que el test estándar es más fácil de lo que parece: todas las demostraciones terminan con el bloque en el mismo sitio y, en el 84 % de los objetivos, el grafo ya contenía un estado casi idéntico. Con los 50 episodios oficiales LeWM acierta el 68 % a 50 pasos; con 250 episodios nuevos, el 44 %, y solo cambiar la semilla aleatoria del planner cambió el resultado de 38 de 250 episodios. En un test más duro, con inicio y objetivo de demostraciones distintas, el planner con grafo logra el 75 % en tareas estándar y el 45 % en las nuevas. Los métodos tercero y cuarto atacan esa brecha: el tercero aprovecha la simetría de la física de Push-T (desplazar, rotar o reflejar la mesa) para transformar segmentos de memoria y rellenar huecos. Al borrar los estados cercanos al objetivo, el éxito había caído del 93 % al 32 %; con segmentos transformados, según el texto, vuelve al 85 %.
«After 600 experiments, here's what I discovered about JEPA world models» · puesto 30 · 279 puntos · enviado por halcdev
Lo que dicen los comentarios
Los comentarios se reparten entre lo técnico y lo accesorio. El más votado cuestiona que el autor se apoye tanto en objetivos extraídos de demostraciones, cuando la tarea real sería moverse entre dos poses arbitrarias. Otro lector echa en falta resultados novedosos, porque la planificación jerárquica y los subobjetivos ya se conocen, y otro le replica que en un blog personal nadie debería esperar eso. También hay dudas sobre el alcance de JEPA: si es una alternativa a las limitaciones de los LLM o un enfoque limitado a robótica. Alguien recuerda que MCTS también resuelve Push-T sin entrenamiento. Buena parte de los comentarios trata del diseño de la web: los tonos de color en móvil, el efecto de fondo en pantallas OLED, las animaciones y la tipografía.
¿Por qué apoyarse tanto en ejemplos de las demostraciones? La tarea real es moverse entre dos poses arbitrarias. Si el conjunto de demostraciones es estadísticamente raro, uno choca siempre con eso y no demuestra que generalice.
Aprender con las manos es genial, pero quizá convenga no hablar de «descubrir»: la planificación jerárquica, los subobjetivos y el action chunking se conocen bien. Esperaba resultados novedosos; esto es más bien la crónica de un aprendizaje personal.
No creo que uno tenga derecho a esperar un descubrimiento novedoso para la ciencia salvo que lea un artículo científico. Que esté planteado como «descubrí» y en un blog personal debería bastar para entenderlo.
Sabía poco de JEPA y creía que era una alternativa a las limitaciones de los LLM. Según el artículo parece un nicho: mejorar movimientos robóticos. ¿Pueden aplicarse sus técnicas a problemas más amplios, como los transformers?
Esta noticia la ha redactado una inteligencia artificial a partir de las fuentes citadas, con el criterio editorial de El Autómata (equilibrio, atribución y solo hechos publicados). Puede contener errores: consulta las fuentes originales. Modelo: claude-sonnet-5.5.